
ジェヴ
Jev
の使い方・機能・解決する業務課題
ブックマークする
Jev(ジェヴ)とは?
Jev(ジェヴ)は、TypeSafe AIが2026年9月15日に公開した「System Oneモデル」です。LLMと違って文章を生成せず、渡したテキストやJSONに対して、Choice(分類)・Score(採点)・Noul(0〜1の真偽)という型の決まった値を、確率とconfidenceつきで返します。文字列が返らないためパースも検証も不要で、公式公表値で応答70〜500ms、入力100万トークンあたり$0.042、出力トークンは無料。1回のリクエストに質問を何個積んでも並列に評価されるため応答時間がほとんど変わらず、問い合わせの振り分け・LLMのガードレール・RAGの再ランキングといった「大量の同じ判断」に向きます。2026年9月時点では早期アクセス(ウェイトリスト制)で、公式は日本語を含むCJKの精度は英語より低いと明記しています。
解決する業務課題
「Jev」のサービス詳細
Jevとは
Jev(ジェヴ)は、サンフランシスコのTypeSafe AIが2026年9月15日に公開したSystem Oneモデルです。LLMのように文章を生成するのではなく、渡した状態(テキストまたはJSON)に対して、型の決まった判断を確率つきで返すことだけを行います。
返ってくるのは "technical" のようなラベル、1.6 のような段階値、0.92 のような確率です。文字列が生成されないため、パースする処理も、壊れた出力を弾くリトライも要りません。用途は、問い合わせの振り分け、LLMのガードレール、RAGの再ランキングのように同じ形式の判断を大量に繰り返す処理です。
2026年9月19日時点では早期アクセス(ウェイトリスト制)で、ウェイトリストに登録した順に案内されています。
「System Oneモデル」という位置づけ
名前はダニエル・カーネマンの『ファスト&スロー』に由来します。速く自動的な思考がSystem 1、遅く意識的な思考がSystem 2。TypeSafe AIの主張は、現在のLLMはすべてSystem 2に寄って作られているが、業務システムが必要としている判断の大半はSystem 1の仕事だというものです。
「このチケットはどの部署か」「この文は緊急か」という判断に、毎回チェーン・オブ・ソートの機械を持ち出していたのがこれまでの構成でした。
LLMに分類させる構成
- 返るのは文字列。JSONモードでも検証が要る
- 定義していないラベルを勝手に作ることがある
- 確率が出ないので迷いが見えない
- 逐次サンプリングで数秒〜数十秒
- 質問を増やすとそのぶん遅く、高くなる
Jevに判断させる構成
- 返るのは型の決まった値。パース不要
- 選択肢は定義した集合の外に出ない
- 確率分布とconfidenceが必ず付く
- 並列評価で70〜500ms
- 質問を増やしても応答時間はほぼ変わらない
TypeSafe AIは、この振る舞いを得るために新しいアーキテクチャ・新しいサンプラー・RLCD(Reinforcement Learning for Calibrated Decisions)という独自の学習アルゴリズムを組み合わせたと説明しています。RLHFが人間の好みに最適化した結果、モード崩れ・過信・信頼性の欠如を招き、人間が確認に入らざるを得なくなった——その反対方向に進んだ、というのが公式の主張です。
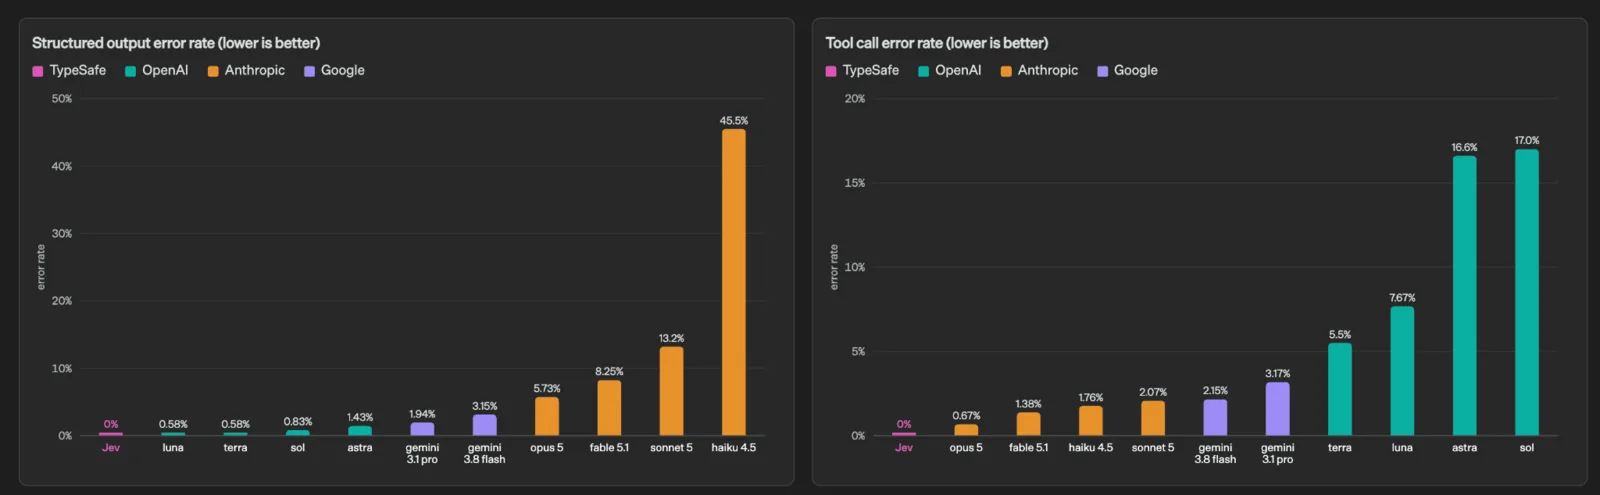
型が壊れた割合の比較(左が構造化出力、右がツール呼び出し。いずれも低いほど良い)。出典: TypeSafe AI 公式ブログ
公式が公開しているのがこの2つのグラフです。構造化出力のエラー率はJevが0%、GPT-5.6 Lunaが0.58%、Claude Haiku 4.5が45.5%。ツール呼び出しのエラー率はJevが0%、Claude Opus 5が0.67%、GPT-5.6 Solが17.0%。ここで測っているのは「指定した型どおりに返ってきたか」であって、判断が当たったかではありません。JSONモードを使っていてもリトライ処理が消せない理由が、この数字に出ています。
公式公表値
出力トークンは無料
stateは32kまで
DCVC主導・2026年9月
3つの質問型で、返ってくる値が決まる
Jevに投げられる質問は3種類だけです。この制約が、型が壊れない理由そのものになっています。
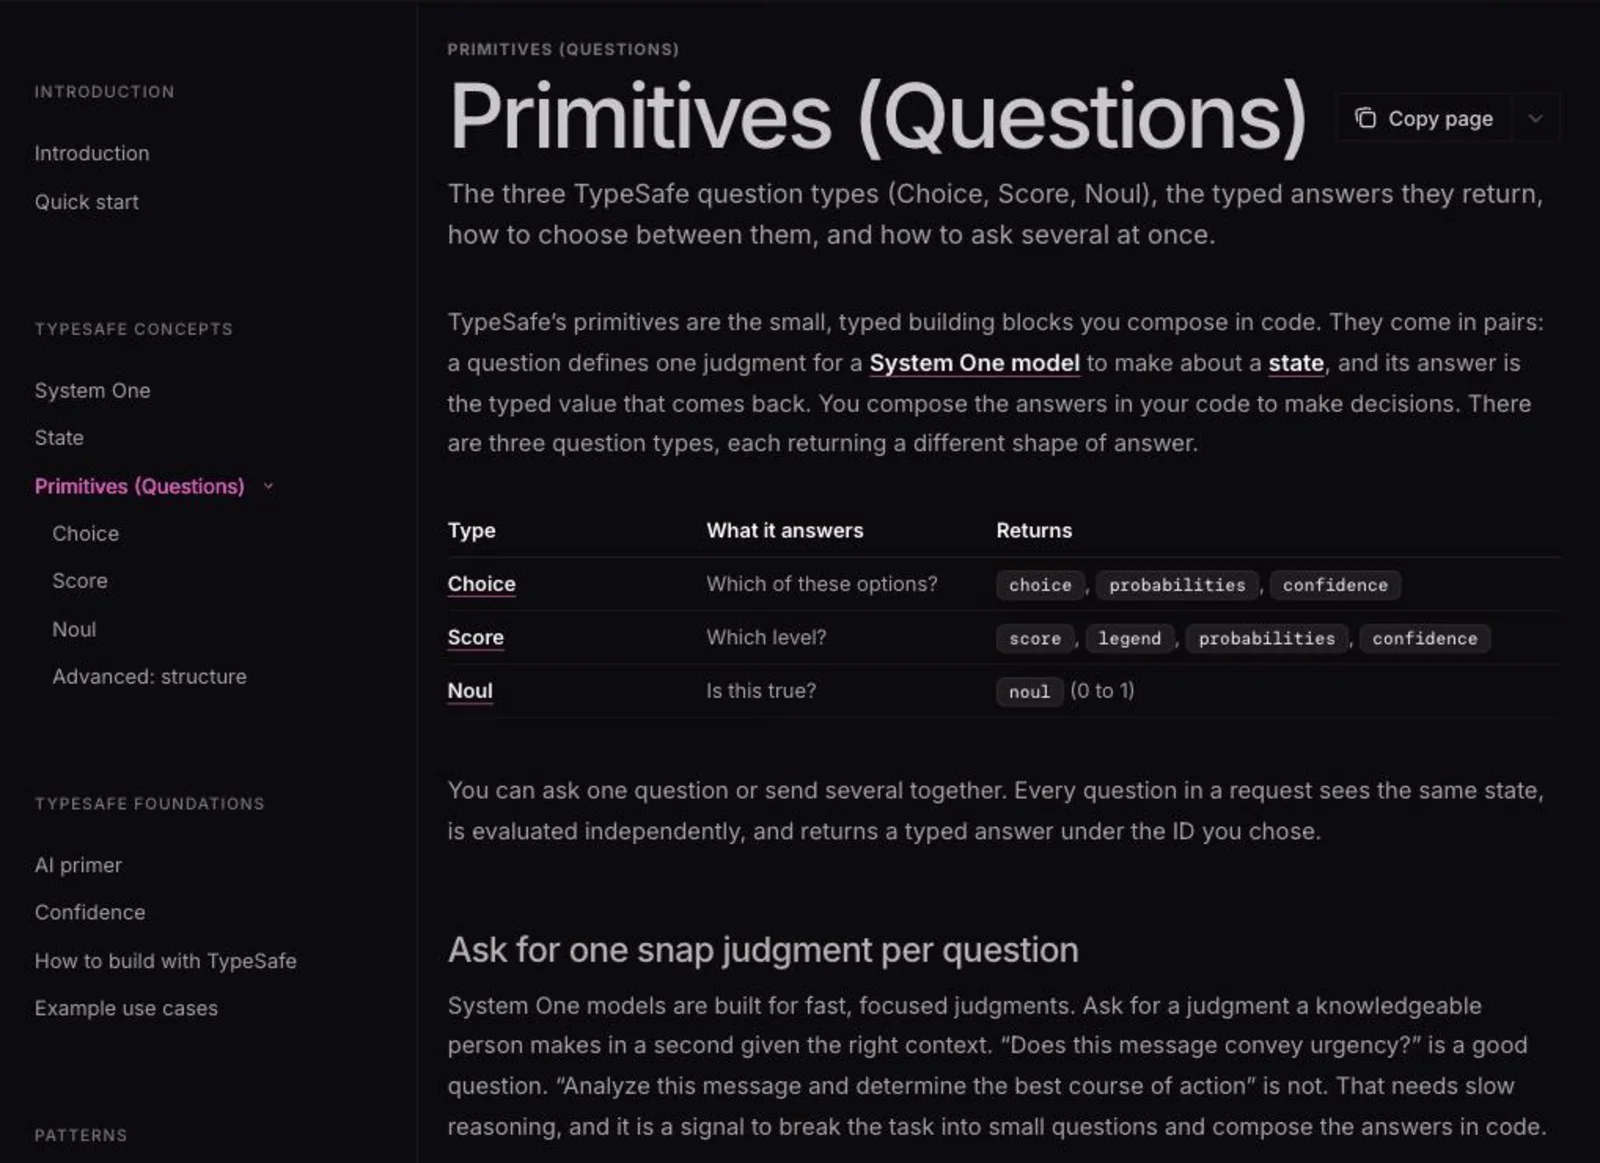
公式ドキュメントの Primitives ページ。左のナビゲーションに Choice・Score・Noul と Confidence・Patterns が並ぶ。出典: TypeSafe AI 公式ドキュメント
01Choice|決まった選択肢から1つ選ぶ
順序のない分類。チケットの振り分け先、文書の種別、言語判定など。
- choice — 選ばれたキー
- probabilities — 全選択肢の確率分布
- confidence — 分布がどれだけ1つに尖っているか(0〜1)
02Score|順序のある段階で採点する
バグの深刻度、顧客の苛立ち、習熟度など、段階に意味がある尺度。
- score — 段階のあいだの値を取る(例: 1.6)
- legend — 段階と番号の対応表
- probabilities / confidence — Choiceと同様
03Noul|「その文は真か」を0〜1で返す
Jev独自の型。真偽を尋ねるが、返るのは true / false ではなく確率。
- noul — 1に近ければ「はい」、0に近ければ「いいえ」、0.5付近は判断がつかない
- confidence は無い — 確率そのものが確信度を表すため
公式が注意しているのは、ScoreとNoulの取り違えです。「習熟度が中程度」をNoulの0.5で表してはいけません。それは「中程度だ」ではなく「はいかいいえか分からない」という意味になります。
質問をいくつ積んでも、応答時間は変わらない
Jevの設計でもっとも効くのがここです。1回のリクエストに入れた質問はすべて並列に評価されるため、公式ドキュメントは「質問を追加しても応答時間は通常まったく増えない」と書いています。
そこから、分岐先でしか使わない質問も最初からまとめて投げる投機的ファンアウトという書き方が生まれます。チケットが機能要望だったら「バグの深刻度」の結果は捨てればよく、それでも1往復で済みます。LLMなら「分類する→結果を見てもう一度聞く」の往復が必要だった部分です。
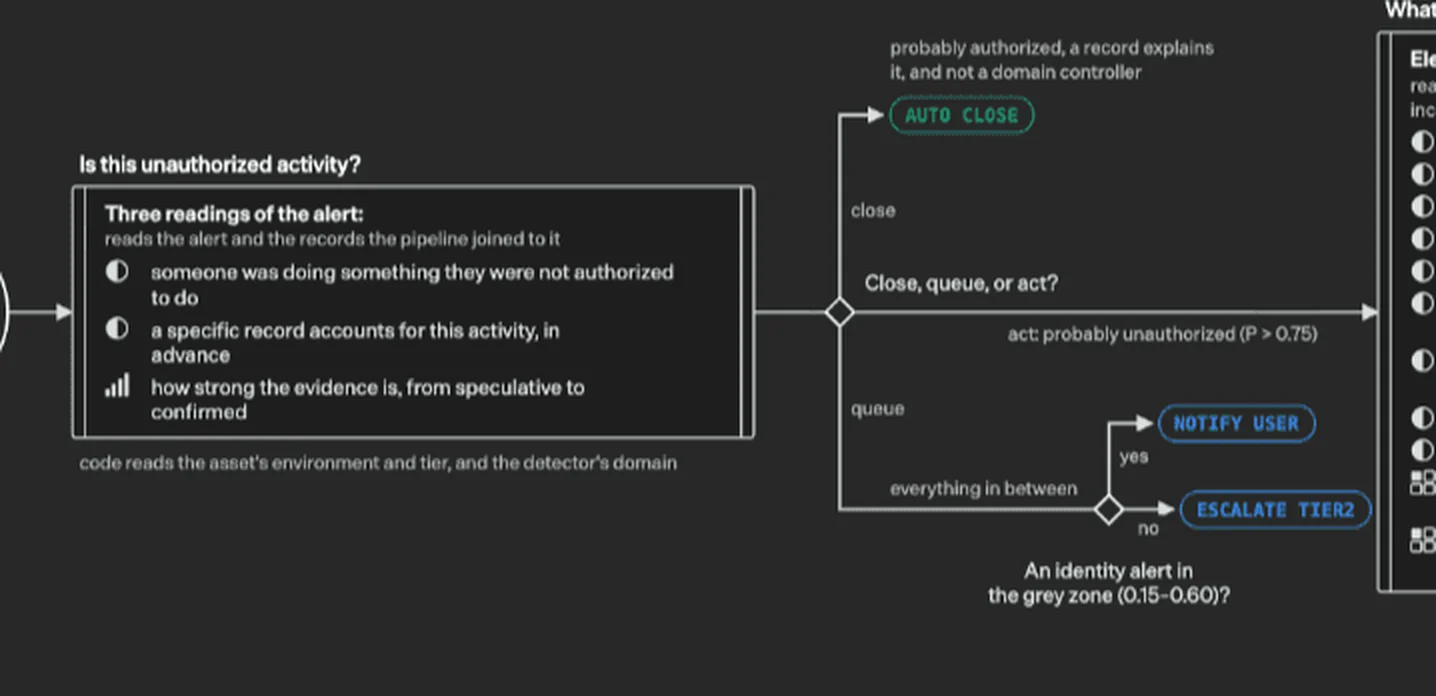
公式が示すインシデント振り分けの一部。確率のしきい値(P > 0.75、0.15〜0.60)がそのまま分岐条件になっている。出典: TypeSafe AI 公式ブログ(図の一部を抜粋)
公式が出しているセキュリティアラートの例が分かりやすい実装です。1本のアラートに対して「許可されていない行為か」をBoolで2問、「証拠の強さ」をScoreで1問投げ、確率が0.75を超えたら対処、0.15を下回ったら自動クローズ、その間(0.15〜0.60)は人に通知するかTier2にエスカレーションと分けています。しきい値がそのまま運用ルールになっている形です。
使い方
-
ウェイトリストに登録する
公式サイトの「Join Waitlist」から登録します。2026年9月時点では早期アクセス中で、公式は「できるだけ速く順に案内している」としています。
-
APIキーを発行する
console.typesafe.aiでアカウントを作り、APIキーを発行します。キーは発行時の1回しか表示されません。環境変数名はTYPESAFE_API_KEYです。 -
Playgroundで質問文を詰める
コンソールのPlaygroundは、左にstate(プレーンテキスト)、右にquestions(JSON)を書く画面で、実測のレイテンシも表示されます。SDKを入れる前に、ここで
instructionsとcriteriaの文言を固めるのが早道です。 -
SDKから呼ぶ
Python は
pip install typesafe-sdk、JavaScript/TypeScript はnpm install @typesafe-ai/sdk(Node.js 20以降)です。from typesafe_sdk import Choice, Noul, Score, TypeSafeClient client = TypeSafeClient() response = client.system_one( state=ticket, questions={ "department": Choice( instructions="Which team should handle this", criteria={ "billing": "Payment or subscription issues", "technical": "Bugs or integration problems", "sales": "Pricing or account questions", }, ), "frustration": Score( instructions="How frustrated the customer appears", criteria=["Calm", "Frustrated but civil", "Very angry"], ), "is_urgent": Noul( instructions="The message conveys urgency or time-sensitivity", ), }, ) print(response.answers["department"].choice) # "billing" print(response.answers["frustration"].score) # 1.035 print(response.answers["is_urgent"].noul) # 0.999 -
confidenceでしきい値を決める
返ってきた
confidenceで、自動実行するか人に回すかを分けます。公式の目安は0.9超で自動実行、0.5〜0.9は確認かレビュー、0.5未満は実行しない。操作の重さごとにしきい値を変えるのが要点です。 -
コーディングエージェントに書き換えさせる
公式がエージェント向けスキルを配布しています。Claude Codeなら
claude plugin marketplace add typesafe-ai/skillsとclaude plugin install typesafe@typesafe-aiの2行。既存コードの中で壊れやすいパース処理をしている箇所を見つけて置き換える用途に使えます。ただし公式自身が「エージェントは質問文を書くのが得意ではないので、一緒に直す前提で」と書いています。
機能
01モデルと入出力
- jev-1.13.0 / jev-latest / jev-preview — 2026年9月時点で公開されているのはJev 1.13の系列のみ
- stateの形式 — 文字列/JSONオブジェクト/文字列の配列。会話スレッドは配列で渡せる
- テキストのみ — 画像・音声・動画は非対応
- calibrated confidence — Choice・Scoreは確率分布から算出したconfidenceが必ず付く
02開発者向けの提供物
- HTTP API — `POST https://api.typesafe.ai/v1/systemone`。認証は Bearer トークン
- Python SDK — 同期クライアントと非同期クライアント、リトライポリシー、例外型
- JavaScript / TypeScript SDK — 質問定義から戻り値の型が推論される
- エージェント用スキル — Claude Code その他のエージェントに、3つの質問型と設計パターンの知識を読み込ませる
03公式が示している設計パターン
- 投機的ファンアウト — 分岐先の質問も1回にまとめて投げる
- confidenceゲート — 確信度を軸に、自動実行・確認・人手を振り分ける
- 複合スコアリング — 複雑な判断を、粒度の細かいScoreに分解する
- 意図ルーティング — 意図と難易度を判定し、適切なLLMへ振り分ける
04クックブック(公式が公開している実装例)
- LLMのガードレール — 入力側で脱獄・プロンプトインジェクション・自傷の兆候、出力側でポリシー違反を検出
- 引用のつき合わせ — LLMの主張が元文書に実在するかを検証
- RAGの通過判定・再ランキング — 取得した文章の関連度を採点してノイズを落とす
- 階層分類・日付抽出・関数呼び出しの対応づけ — 深いタクソノミー、相対日付、自然言語から型付き関数へ
料金
入力トークンのみの従量課金で、出力トークンは無料です(公式表記は「計測するには安すぎる」)。
| 項目 | 内容 |
|---|---|
| 入力単価 | 10億トークンあたり$42(=100万トークンあたり$0.042) |
| 出力単価 | 無料 |
| 無料枠 | コンソールの請求画面に月$5分(2026年9月時点の検証報告) |
| レート制限 | 毎秒250,000トークン/毎分1,200リクエスト(動的に調整・予告なく変更あり) |
| コンテキスト | 1リクエストあたり64,000トークン。stateは最長の質問と合わせて32,000トークンまで |
| 提供形態 | 早期アクセス(ウェイトリスト制) |
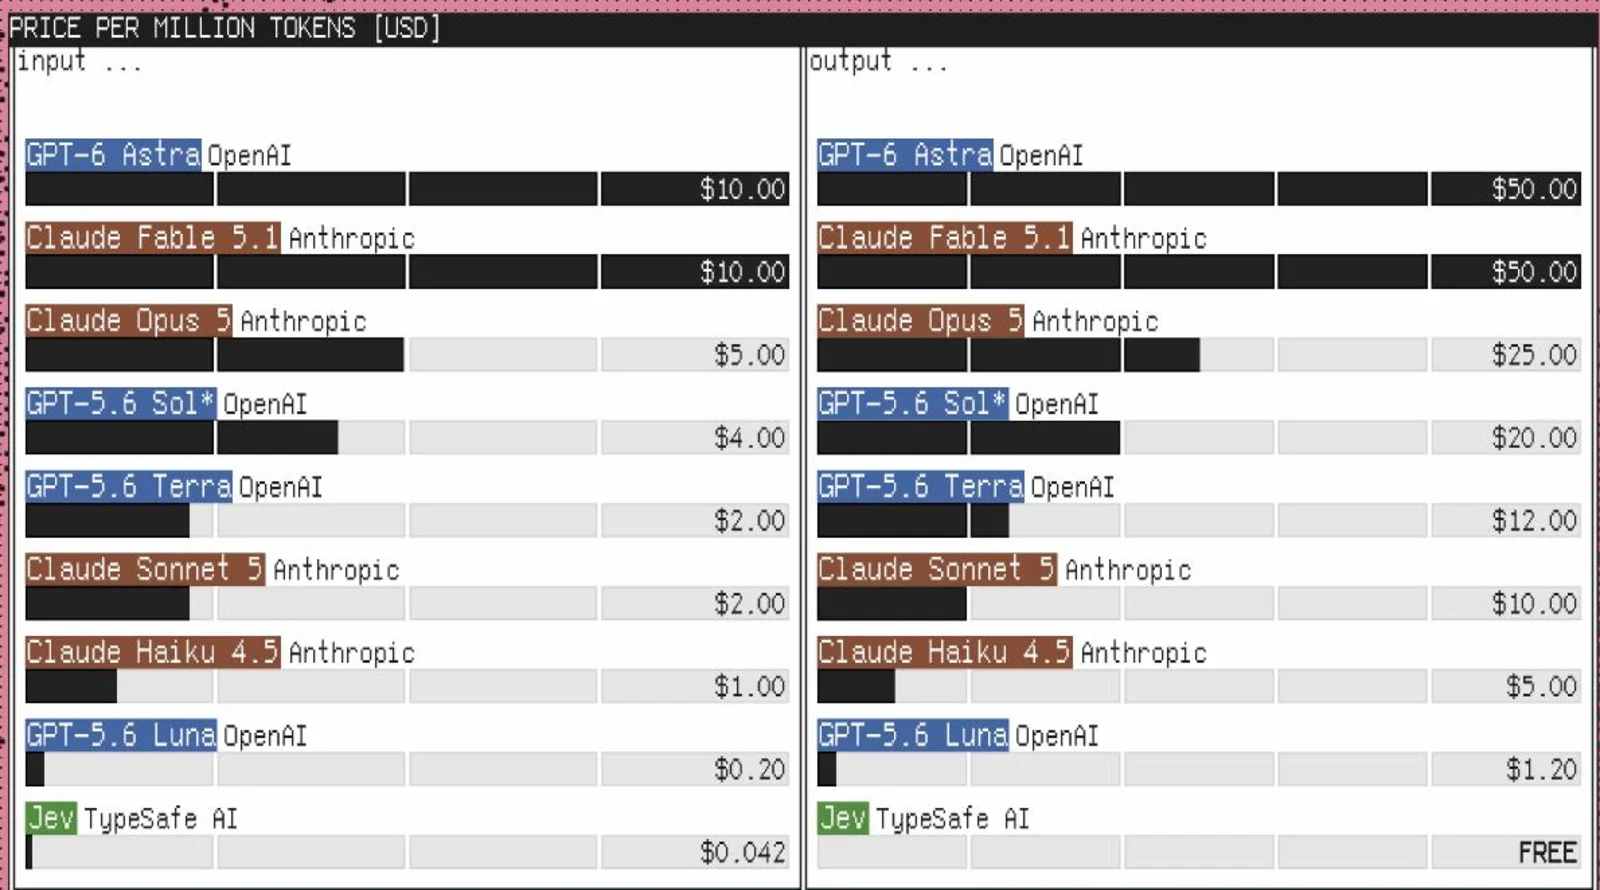
公式サイトが掲げる価格比較。右列の出力単価で、Jev だけが FREE になっている。出典: TypeSafe AI 公式サイト
公式サイトは「Claude Fable 5.1より入力単価が238分の1」「System Oneワークフローで193.6倍速く、444.6倍安い」と掲げ、1件の処理の実測としてJev $0.000081/0.114秒に対し、LLMは$0.013880/8.566秒という数字を出しています。
これらはすべてTypeSafe AI自身の測定です。正解ラベルつきの既存ベンチマークではなく「ワークフローevals」という独自の評価枠組みによるもので、使われた4つのワークフローの中身は公開されておらず、第三者検証もまだ出ていません。桁が違うこと自体は価格表から確かめられますが、自分の処理での倍率は自分で測るのが前提です。
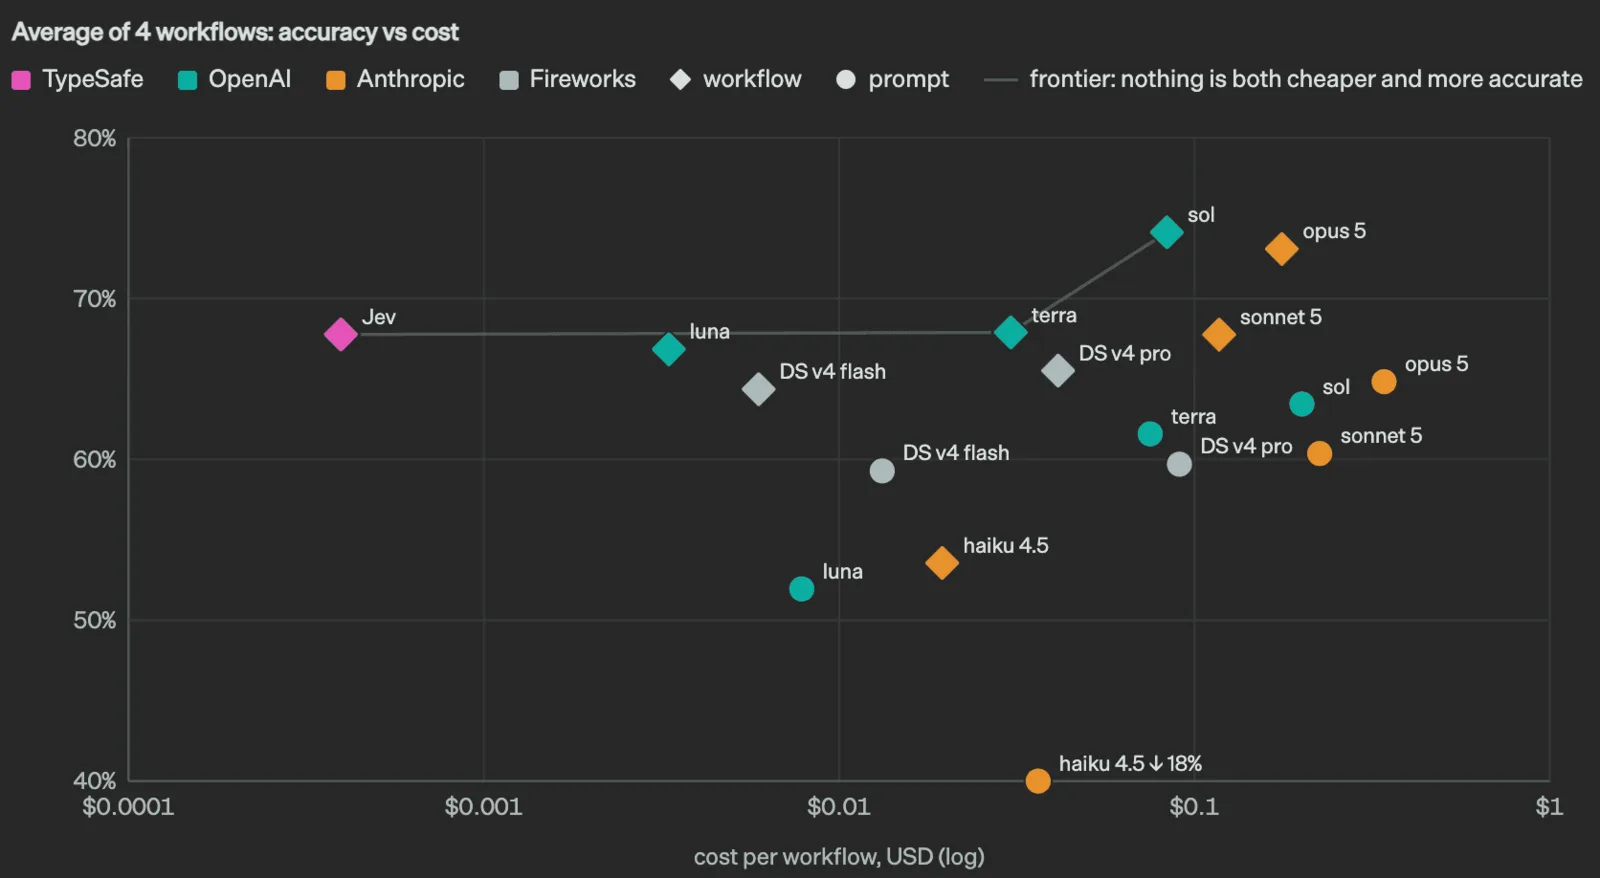
精度とコストの関係。横軸は1ワークフローあたりの費用(対数)。出典: TypeSafe AI 公式ブログ
このグラフが、数字の並びより正確に立ち位置を伝えています。Jevは最高精度のモデルではありません。4つのワークフロー平均の精度は約68%で、GPT-5.6 Solの約74%に6ポイント届いていません。Jevがいるのは「同じくらいの精度を、2桁安く出す」位置です。GPT-5.6 Lunaが約$0.003で約67%、Terraが約$0.04で約68%。Jevはほぼ同じ精度を約$0.0004で出しています。
したがって判断の分かれ目は「Jevが賢いか」ではなく、その処理に6ポイントの精度差を払う価値があるかです。誤りを人が拾える設計(confidenceで回す)になっていれば安いほうが効き、1件の取りこぼしが高くつく処理ならSolのままのほうが安全です。
日本語で使えるか
日本語のstateは渡せますが、公式は「日本語を含むCJKは受け付けるものの、現時点では精度が英語より低い」と明記しています。Jevの第一言語は英語で、最良の性能が出るのは英語入力です。ドキュメント・コンソールも英語のみで、日本語のUIや日本語サポートはありません。
実際に日本語のチケット文で緊急度を判定させた検証では0.97〜0.98が返っており、体感では動いています。ただし「動いた」と「業務で使える精度が出ている」は別です。日本語で使う場合は次の順序を踏みます。
- instructions と criteria は英語で書く — stateは日本語のまま渡し、判定の指示だけ英語にする
- 正解つきデータで一度測る — 過去の問い合わせを100〜300件、人が付けたラベルつきで用意して突き合わせる
- 最初はしきい値を高くして人を残す — confidence 0.9以上だけ自動化し、残りは人に回す
苦手なこと|公式が公開している弱点
TypeSafe AIは、Jev 1.13の不得意領域を model-jaggedness というページで自ら公開しています。導入前に必ず読む場所です。
| 弱点 | 具体的に何が起きるか |
|---|---|
| 書いた通りにしか読まない | 限定表現・否定・暗黙の条件を額面通りに解釈する。「意図した質問」ではなく「書いた質問」に答える |
| 数を数えられない | 文字数・出現回数・件数が信頼できず、対象が大きくなるほど誤差が増える |
| 数値の精度が出ない | 16進値やRGB値の扱いが弱く、2つの値が近いかどうかを確実には判定できない |
| 日付・時刻の比較が弱い | 日付を順序のある量ではなくテキストとして読む。前後関係や期間の計算は不得意 |
| 二重否定・複雑な間接表現に弱い | instructions と criteria が矛盾していると混乱する |
| 無関係な情報が多いと精度が落ちる | stateに判断と関係ない内容が増えるほど精度が下がる |
| 敵対的な入力に脆弱 | stateに混ざった指示や誤導的な書き方に影響される |
加えて、関連する質問どうしの数学的な整合は保証されません。「Aである」と「Aでない」を別々のNoulで聞いても、確率が足して1になるとは限りません。整合が要るなら1つのChoiceにまとめます。
また、テキスト生成には使えません。公式が「生成の訓練を受けていない」と明記しており、無理に連鎖させても質が低く遅いと書かれています。
つくっている会社
TypeSafe AIはサンフランシスコに拠点を置き、2年間のステルス期間を経て2026年9月15日に公開されました。シードラウンドでDCVCを主導投資家として4,000万ドルを調達しています(Forbesは評価額を約2億ドルと報じています)。
RLHFを作った側の人物が、RLHFの副作用(過信・信頼性の欠如)を理由に反対方向のモデルを作っている、という構図が、公開直後に注目を集めた一因になっています。
他のAIモデル・APIとの違い
Jevは汎用LLMの代替ではありません。「LLMにやらせていた仕事の一部を外に出す」ためのものです。
| Jev | 汎用LLM(Claude / ChatGPT / Gemini) | |
|---|---|---|
| 出力 | 型の決まった値+確率 | 文章(文字列) |
| パース・検証 | 不要 | JSONモードでも必要 |
| 応答時間 | 70〜500ms | 数秒〜数十秒 |
| 入力単価(100万) | $0.042 | $0.20〜$10 |
| 出力単価 | 無料 | 入力の約5倍 |
| 得意 | 分類・採点・真偽判定 | 生成・長い推論・対話 |
| 日本語 | 受け付けるが精度は英語より低い | 実用水準 |
- Claude — 文章生成と長い推論の担当。Jevはその前後に挟んでガードレールや出力検証を受け持つ。競合ではなく組み合わせる関係
- ChatGPT — 分類・抽出だけならGPT-5.6 Luna(入力$0.20/100万トークン)という選択肢がある。Jevとの差は約5倍の単価差と、出力課金の有無、パースの要否。すでにOpenAIで組んでいるなら、まず既存の安価モデルで足りるかを確かめてから比較する
- Dify — ワークフローの条件分岐に置いているLLMノードは、選択肢が事前に決まっている判断そのもの。Jevに置き換えると1ステップの待ち時間が秒からミリ秒になる
- Claude Code — 公式スキルを入れると、リポジトリ内の壊れやすいパース処理を見つけてJevの呼び出しに書き換える作業に使える
よくある質問(FAQ)
QJevは無料で使えますか
従量課金ですが、コンソールの請求画面に月5ドル分の無料利用枠があると報告されています(2026年9月時点)。入力100万トークンで$0.042なので、この枠だけでも相当な回数を試せます。利用にはウェイトリストからの案内が必要です。
Q文章の生成・要約はできますか
できません。テキスト生成の訓練を受けていないと公式が明記しています。生成はLLMの仕事で、Jevはその前後の判断を受け持ちます。
Q画像やPDFを渡せますか
渡せません。stateはテキストのみで、文字列・JSONオブジェクト・文字列の配列の3形式です。OCRや文字起こしを通してからテキストとして渡す形になります。
Q「ハルシネーション0%」とは何を指していますか
型が壊れないことを指します。定義していないラベルは出ず、数値は定義した範囲に収まります。判断が正しいという意味ではありません。出力形式の保証と正答率は別の話です。
Qどこから試すのが早いですか
いま本番でLLMに投げている処理のうち、戻り値をJSONでパースしている箇所を1つ選び、同じ入力をPlaygroundに10件流して判定が一致するかを見るのが最短です。そこがJevの守備範囲にあたります。
本ページの情報は2026年9月19日時点で、TypeSafe AIの公式サイト・公式ドキュメント・公式ブログに公開されている内容にもとづきます。早期アクセス中の製品であり、仕様・料金・レート制限は変更される可能性があります。最新の情報は公式サイトをご確認ください。