
Jev
的使用方法、功能与可解决的业务课题
添加书签
Jev是什么?
Jev 是 TypeSafe AI 于 2026 年 9 月 15 日发布的首款「System One 模型」。它与 LLM 不同,不生成文本:传入状态(文本或 JSON),它会返回类型固定的值——Choice(分类)、Score(评分)、Noul(0〜1 的真值),并附带概率与 confidence。因为不返回字符串,所以既不需要解析也不需要校验。官方公布的数字是端到端 70〜500 毫秒、输入每百万 token 0.042 美元,输出 token 免费。一次请求里的问题并行评估,堆再多响应时间也几乎不变,因此适合工单分流、LLM 护栏、RAG 重排序这类「同一种判断大量重复」的场景。截至 2026 年 9 月处于早期访问(候补名单制),官方明确写着包括中文在内的 CJK 文字准确率低于英语。
可解决的业务课题
「Jev」的服务详情
Jev 是什么
Jev 是总部位于旧金山的 TypeSafe AI 于 2026 年 9 月 15 日发布的System One 模型。它不像 LLM 那样生成文本,而只做一件事:针对传入的状态(文本或 JSON),返回带概率的、类型固定的判断。
拿到手的是 "technical" 这样的标签、1.6 这样的等级值、0.92 这样的概率。因为不生成字符串,所以既没有解析处理,也没有为坏输出准备的重试。适用场景是同一种判断大量重复的处理:工单分流、LLM 护栏、RAG 重排序。
截至 2026 年 9 月 19 日,它处于早期访问(候补名单制),按登记顺序邀请。
「System One 模型」这个定位
名字来自丹尼尔・卡尼曼的《思考,快与慢》:系统 1 快速自动,系统 2 缓慢审慎。TypeSafe AI 的主张是,当下的 LLM 全都朝着系统 2 打造,而业务系统真正需要的判断绝大多数是系统 1 的活。
「这张工单归哪个部门」「这句话是否紧急」——此前每一次都得搬出思维链那台机器。
用 LLM 做分类
- 返回的是字符串,JSON 模式下仍要校验
- 可能自创你没定义过的标签
- 没有概率,看不出犹豫
- 顺序采样,几秒到几十秒
- 问题越多,越慢越贵
用 Jev 做判断
- 返回类型固定的值,无需解析
- 答案不会跑出定义好的集合
- 必定附带概率分布与 confidence
- 并行评估,70〜500 毫秒
- 问题变多,响应时间几乎不变
TypeSafe AI 表示,为了得到这种行为,他们组合了全新的架构、全新的采样器,以及名为 RLCD(Reinforcement Learning for Calibrated Decisions)的独有训练算法。官方的说法是:RLHF 为了迎合人类偏好而优化,结果带来了模式坍缩、过度自信与可靠性不足,最终不得不让人类留在回路中——他们选择了相反的方向。
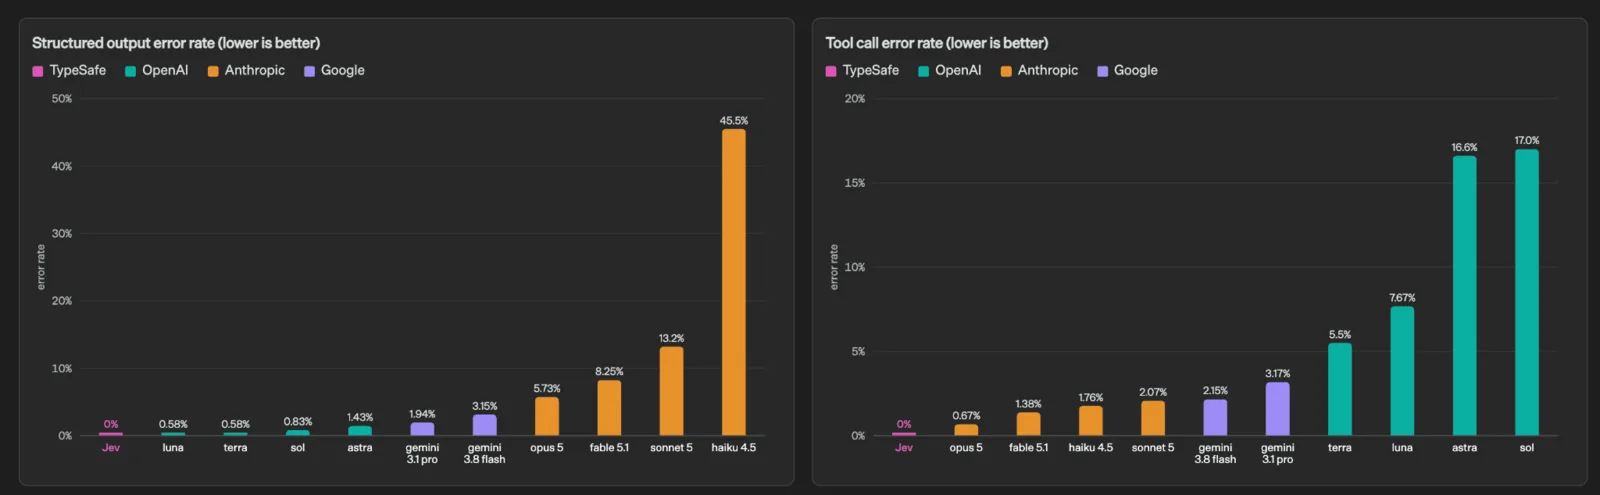
类型出错比例的对比(左为结构化输出,右为工具调用,均为越低越好)。出处:TypeSafe AI 官方博客
官方公开的就是这两张图。结构化输出错误率:Jev 为 0%,GPT-5.6 Luna 为 0.58%,Claude Haiku 4.5 为 45.5%。工具调用错误率:Jev 为 0%,Claude Opus 5 为 0.67%,GPT-5.6 Sol 为 17.0%。这里量的是「有没有按指定类型返回」,而不是判断对不对。即使用了 JSON 模式也甩不掉重试逻辑,原因就写在这组数字里。
官方公布值
输出 token 免费
state 上限 32k
DCVC 领投・2026年9月
三种提问类型决定返回什么
能提的问题只有三种。这个约束本身,就是类型不会坏的原因。
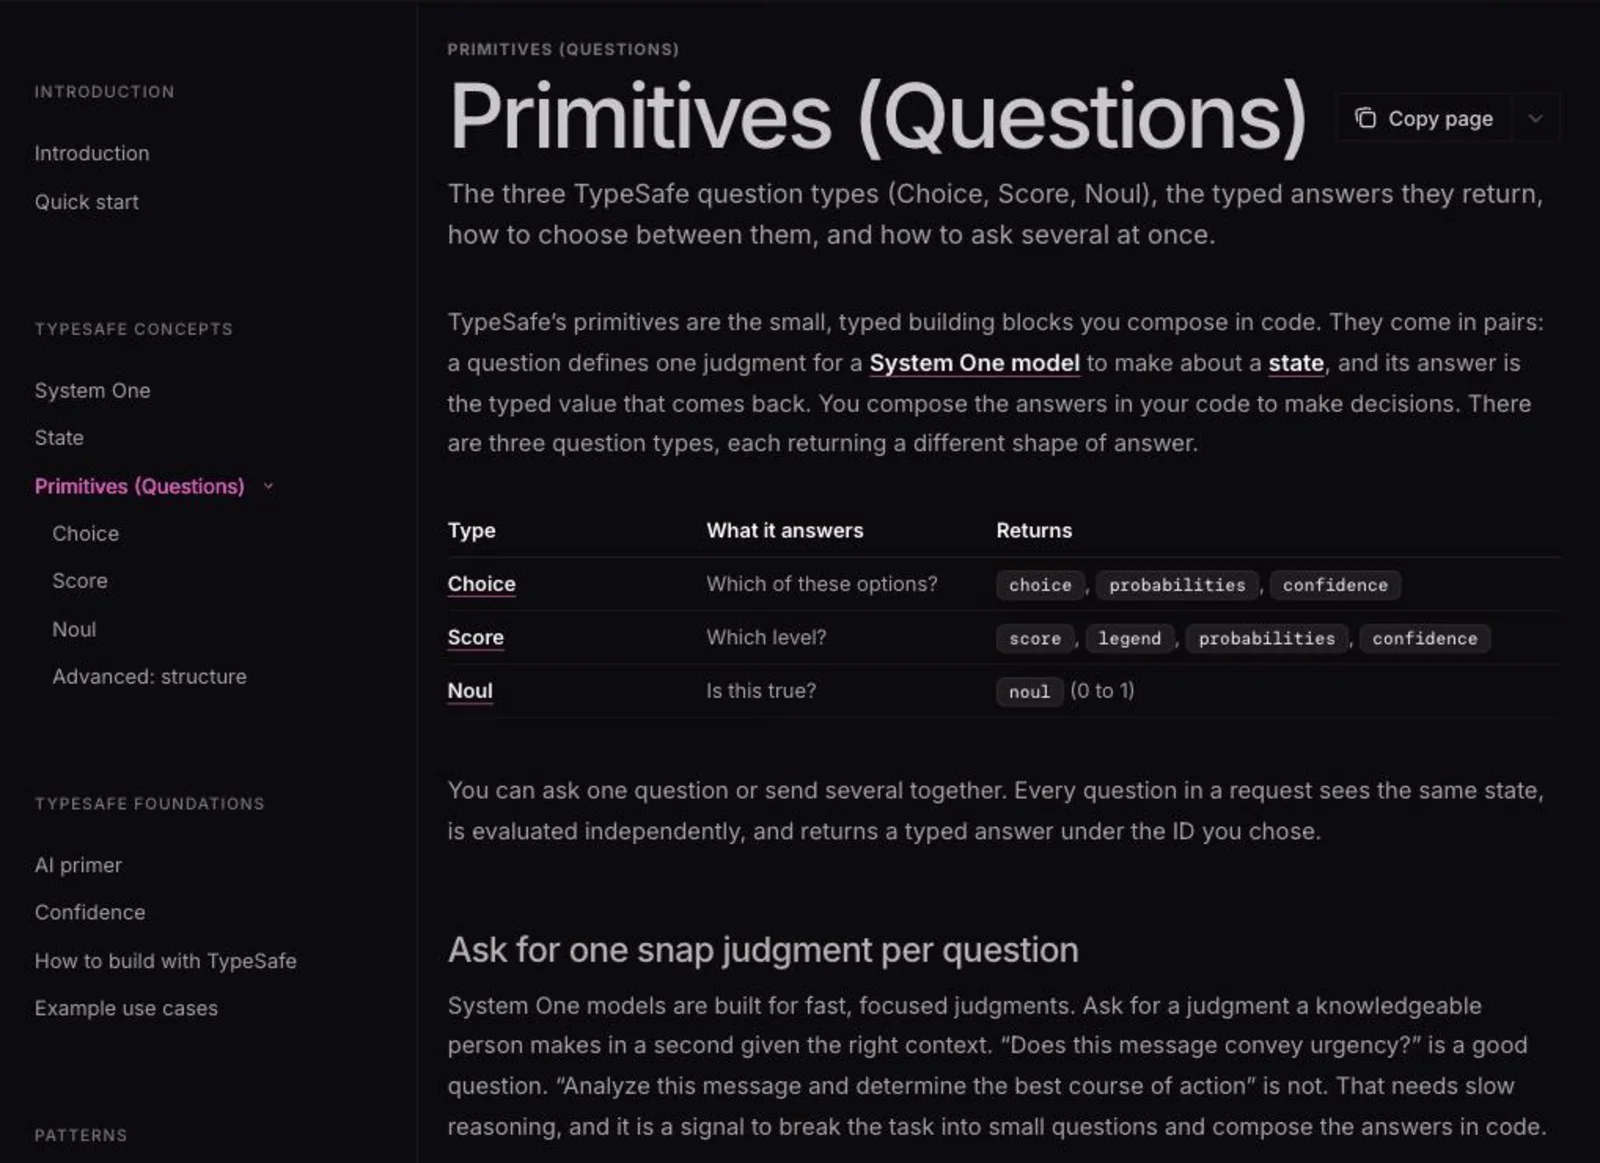
官方文档的 Primitives 页面,左侧导航依次是 Choice、Score、Noul 以及 Confidence、Patterns。出处:TypeSafe AI 官方文档
01Choice|从固定选项中选一个
无顺序的分类:工单分流、文档类别、语种判定。
- choice — 选中的键
- probabilities — 全部选项的概率分布
- confidence — 分布有多集中(0〜1)
02Score|在有序的等级上评分
等级本身有含义的量表:缺陷严重度、客户不满程度、熟练度。
- score — 会取等级之间的值(例如 1.6)
- legend — 等级与编号的对照表
- probabilities / confidence — 与 Choice 相同
03Noul|「这句话为真的概率是多少」
Jev 独有的类型。问是非题,但返回的是概率而非布尔值。
- noul — 接近 1 是「是」,接近 0 是「否」,0.5 附近表示判断不了
- 没有 confidence 字段 — 概率本身就代表确信度
官方提醒不要混淆 Score 与 Noul。「熟练度中等」不能用 Noul 的 0.5 表示,那意思是「无法判断是或否」。
问题堆多少个,都不会更慢
这是设计上最见效的一点。一次请求里的问题全部并行评估,官方文档写明「增加问题通常完全不会增加响应时间」。
由此产生了投机式 fan-out:连只在某个分支才用得上的问题也一起发。如果工单其实是功能需求,把缺陷严重度的结果扔掉就行——仍然只用了一个来回,而 LLM 需要两个。
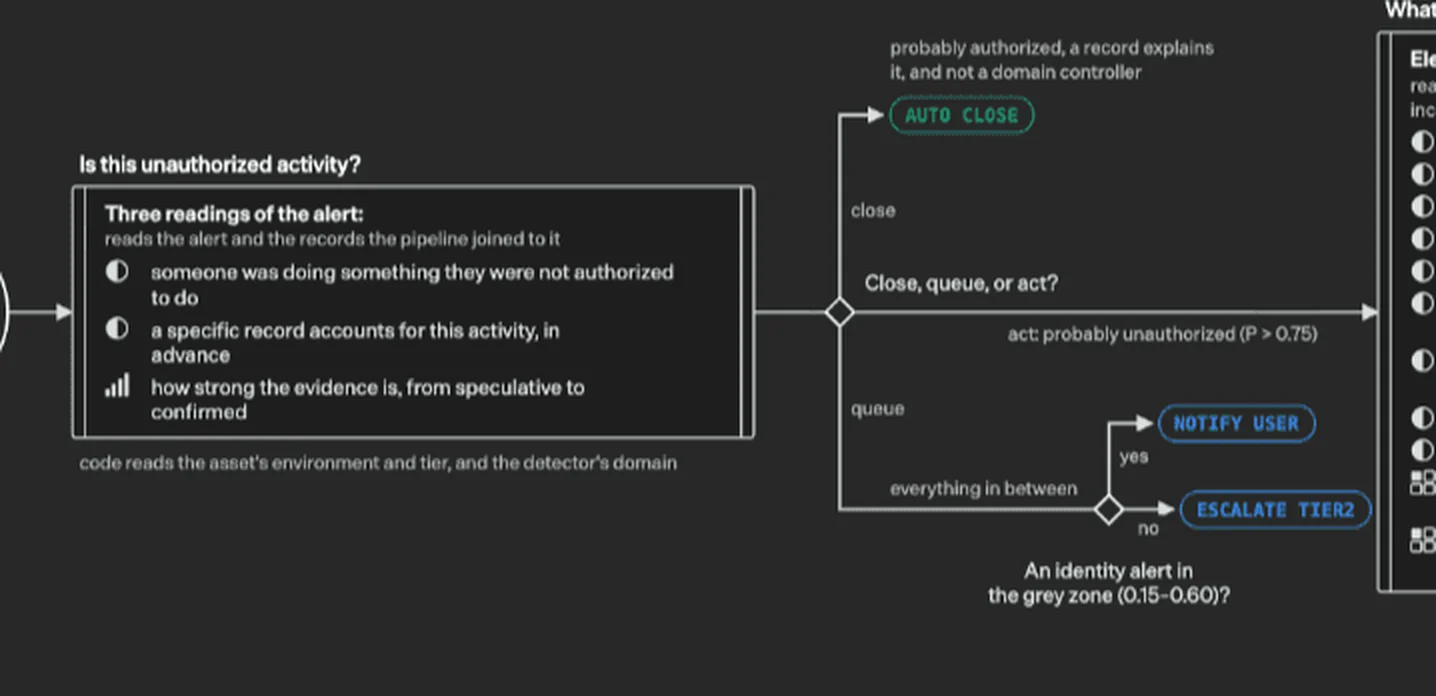
官方给出的事件分流流程的一部分。概率阈值(P > 0.75、0.15〜0.60)本身就是分支条件。出处:TypeSafe AI 官方博客(节选自整张图)
官方给出的安全告警示例是最清楚的一种实现。对一条告警,用 2 个 Bool 问「是否是未授权行为」、用 1 个 Score 问「证据有多强」,然后:概率高于 0.75 就处置,低于 0.15 就自动关闭,介于两者之间(0.15〜0.60)则通知用户或升级到 Tier 2。阈值本身就是运营规则。
使用方法
-
加入候补名单
在官网点击「Join Waitlist」登记。2026 年 9 月时点处于早期访问,官方称「正在尽快按顺序邀请」。
-
生成 API 密钥
在
console.typesafe.ai建号并生成密钥。密钥只在生成时显示一次。环境变量名是TYPESAFE_API_KEY。 -
在 Playground 里磨问题的措辞
控制台的 Playground 左侧写 state(纯文本),右侧写 questions(JSON),并显示实测延迟。装 SDK 之前先在这里把
instructions与criteria定下来。 -
用 SDK 调用
Python 是
pip install typesafe-sdk,JavaScript/TypeScript 是npm install @typesafe-ai/sdk(需 Node.js 20 以上)。from typesafe_sdk import Choice, Noul, Score, TypeSafeClient client = TypeSafeClient() response = client.system_one( state=ticket, questions={ "department": Choice( instructions="Which team should handle this", criteria={ "billing": "Payment or subscription issues", "technical": "Bugs or integration problems", "sales": "Pricing or account questions", }, ), "frustration": Score( instructions="How frustrated the customer appears", criteria=["Calm", "Frustrated but civil", "Very angry"], ), "is_urgent": Noul( instructions="The message conveys urgency or time-sensitivity", ), }, ) print(response.answers["department"].choice) # "billing" print(response.answers["frustration"].score) # 1.035 print(response.answers["is_urgent"].noul) # 0.999 -
用 confidence 设阈值
用返回的
confidence区分自动执行与转人工。官方参考值是:高于 0.9 自动执行,0.5〜0.9 确认或复核,低于 0.5 不执行。要点是按操作的轻重分别设定阈值。 -
让编码代理来改写
官方发布了面向代理的 skill。Claude Code 用
claude plugin marketplace add typesafe-ai/skills与claude plugin install typesafe@typesafe-ai两行即可。适合在现有代码里找出脆弱的解析处理并替换。不过官方自己也写道:「代理不太擅长写问题,请做好一起修改的准备」。
功能
01模型与输入输出
- jev-1.13.0 / jev-latest / jev-preview — 2026 年 9 月时点公开的只有 Jev 1.13 系列
- state 的形式 — 字符串/JSON 对象/字符串数组。会话线程可用数组传入
- 仅文本 — 不支持图像、音频、视频
- calibrated confidence — Choice 与 Score 必定附带由分布算出的 confidence
02面向开发者提供的东西
- HTTP API — `POST https://api.typesafe.ai/v1/systemone`,Bearer 令牌认证
- Python SDK — 同步与异步客户端、重试策略、异常类型
- JavaScript / TypeScript SDK — 从问题定义推导返回值类型
- 代理用 skill — 让 Claude Code 等代理掌握三种提问类型与设计模式
03官方给出的设计模式
- 投机式 fan-out — 把分支才用的问题也放进同一次调用
- confidence 闸门 — 以确信度为轴,分配自动执行、确认、人工三条路径
- 复合评分 — 把复杂判断拆成粒度更细的 Score
- 意图路由 — 判定意图与难度,再分发给合适的 LLM
04官方公开的实现示例(cookbook)
- LLM 护栏 — 入口侧检测越狱、提示注入、自伤倾向,出口侧检测违规内容
- 引用核对 — 验证 LLM 的论断在原文档中是否真的存在
- RAG 段落过滤与重排序 — 给取回的文本打分,先滤掉噪声
- 层级分类、日期抽取、函数调用映射 — 深层分类体系、相对日期、自然语言到类型固定的函数
价格
仅对输入 token 按量计费,输出 token 免费(官方原话是「便宜到不值得计量」)。
| 项目 | 内容 |
|---|---|
| 输入单价 | 每十亿 token 42 美元(=每百万 token 0.042 美元) |
| 输出单价 | 免费 |
| 免费额度 | 控制台账单页显示每月 5 美元(2026 年 9 月时点的实测报告) |
| 速率限制 | 每秒 250,000 token/每分钟 1,200 次请求(动态调整,可能不经通知变更) |
| 上下文 | 单次请求 64,000 token;state 与最长的问题合计不超过 32,000 token |
| 提供形态 | 早期访问(候补名单制) |
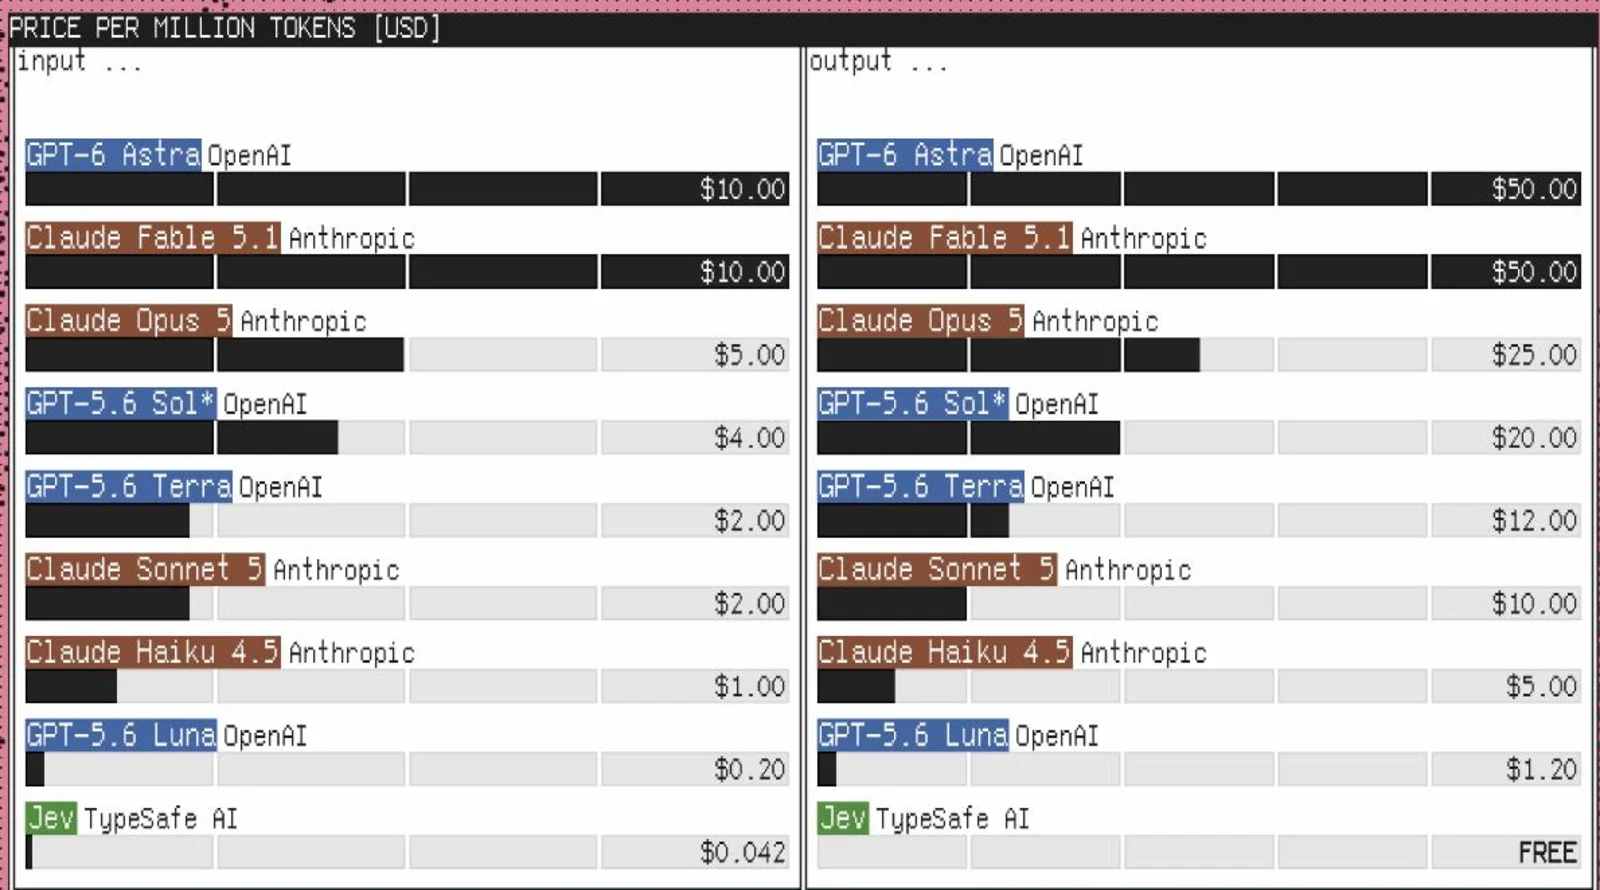
官网主打的价格对比。右侧输出单价一栏,只有 Jev 写着 FREE。出处:TypeSafe AI 官网
官网打出「输入单价比 Claude Fable 5.1 低 238 倍」「在 System One 工作流上快 193.6 倍、便宜 444.6 倍」,并给出单次处理的实测:Jev 为 0.000081 美元/0.114 秒,LLM 为 0.013880 美元/8.566 秒。
这些数字全部是 TypeSafe AI 自己的测量。它们出自自建的「workflow evals」评测框架而非带标准答案的既有基准,所用的四个工作流内容未公开,也还没有第三方验证。量级差距可以从价目表确认,但你自己那套处理的倍率,要自己测。
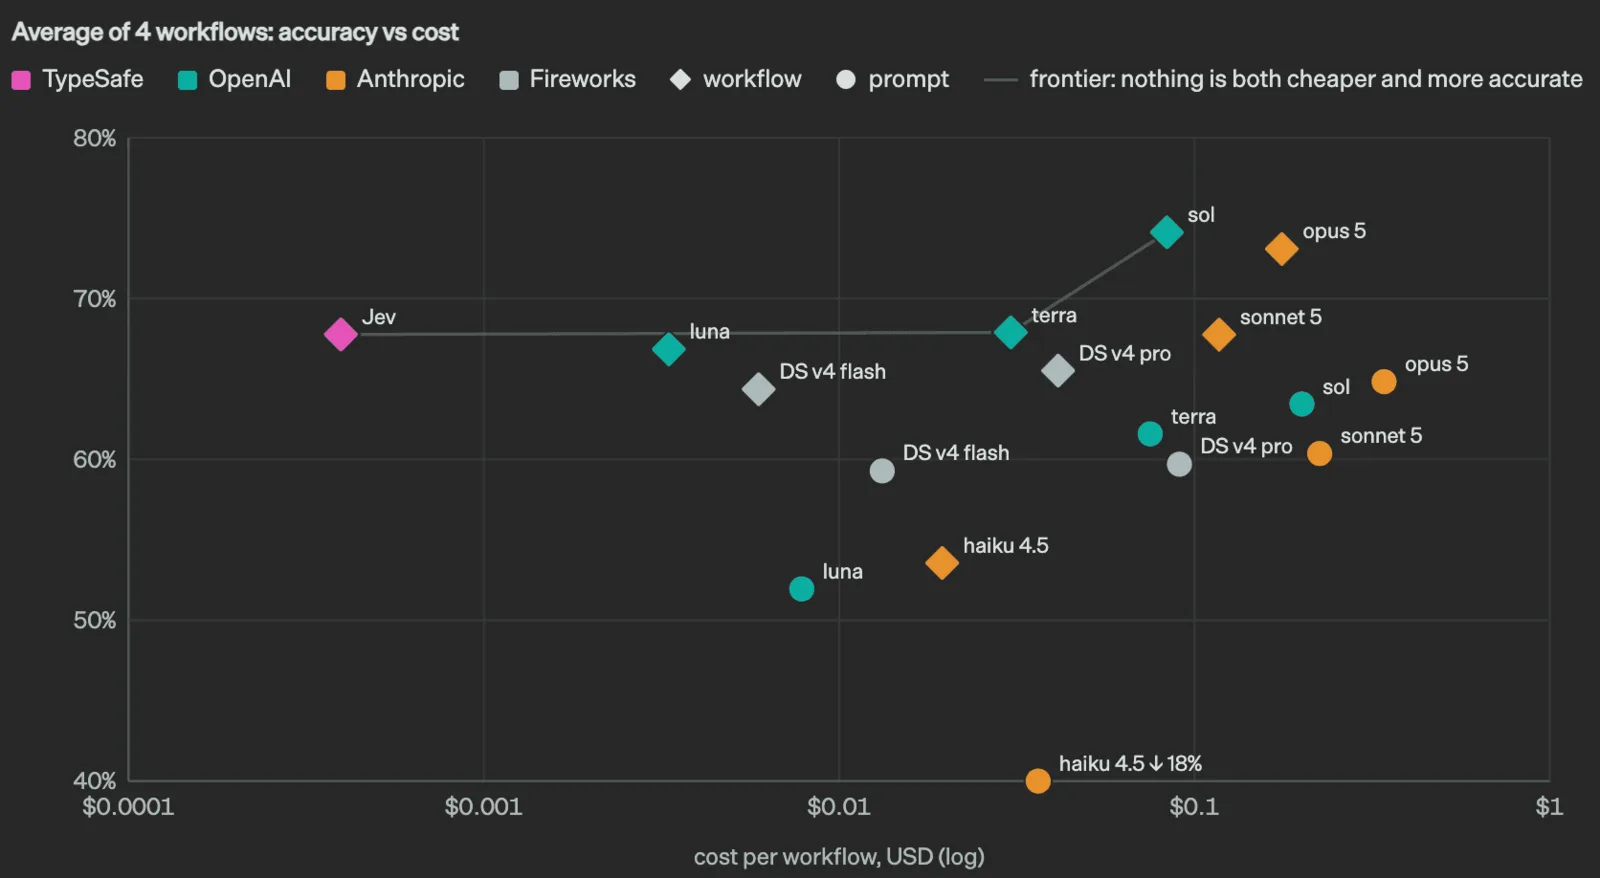
精度与成本的关系,横轴是每个工作流的费用(对数刻度)。出处:TypeSafe AI 官方博客
这张图比任何倍率都更准确地说明了 Jev 的位置。Jev 并不是精度最高的模型。四个工作流的平均精度约为 68%,比 GPT-5.6 Sol 的约 74% 低了 6 个百分点。Jev 所处的位置是「用低两个数量级的成本,做到差不多的精度」:Luna 约 $0.003 做到约 67%,Terra 约 $0.04 做到约 68%,而 Jev 用约 $0.0004 做到约 68%。
所以判断的分水岭不是「Jev 聪不聪明」,而是这个处理值不值得为 6 个百分点的精度买单。如果设计上已经把拿不准的交给人(用 confidence 分流),便宜就更划算;如果漏掉一条的代价很高,留在 Sol 上更稳妥。
中文等非英语输入能用吗
可以传非英语的 state,但官方明确写着 CJK 文字的准确率低于英语。Jev 的第一语言是英语,英语输入才是性能最好的场景。文档与控制台仅有英文,没有中文界面或中文支持。
用日语实测紧急度判定返回了 0.97〜0.98,说明确实能跑。但「跑得起来」和「达到能投产的精度」是两回事。推进顺序如下。
- instructions 与 criteria 用英语写 — state 保持原语言,只把判定指令换成英语
- 先用带标准答案的数据测一遍 — 准备 100〜300 条历史数据与人工标注来对照
- 一开始把阈值设高,保留人工 — 只自动处理 confidence 0.9 以上的
不擅长什么
TypeSafe AI 在名为 model-jaggedness 的页面上主动公开了 Jev 1.13 的短板。投产前必读。
| 弱点 | 具体会发生什么 |
|---|---|
| 只按字面读 | 限定词、否定、隐含条件都按字面理解。回答的是「你写下的问题」而非「你想问的问题」 |
| 数不清数量 | 字符数、出现次数、条目数都不可靠,对象越大误差越大 |
| 数值精度不足 | 对十六进制与 RGB 值处理弱,无法可靠判断两个值是否接近 |
| 日期时间比较弱 | 把日期当文本而非有序的量来读,前后关系与时长计算不可靠 |
| 双重否定与复杂间接表达 | instructions 与 criteria 矛盾时会混乱 |
| 无关信息多了就掉精度 | state 中与判断无关的内容越多,准确率越低 |
| 对对抗性输入脆弱 | 混进 state 的指令与误导性表述会产生影响 |
此外,相关问题之间的数学一致性并不保证:分别用两个 Noul 问「是 A」和「不是 A」,概率未必加起来等于 1。需要一致性就合并成一个 Choice。
还有,它不能生成文本——官方写明「没有接受过生成训练」,强行串起来既慢质量又低。
开发这款产品的公司
TypeSafe AI 总部位于旧金山,经过两年潜行后于 2026 年 9 月 15 日亮相,种子轮由 DCVC 领投,融资 4,000 万美元(Forbes 报道估值接近 2 亿美元)。
发明 RLHF 的人,如今以 RLHF 的副作用(过度自信、可靠性不足)为由造出方向相反的模型——这个构图也是它发布后迅速受到关注的原因之一。
与其他 AI 模型・API 的区别
Jev 不是通用 LLM 的替代品,而是「把原本交给 LLM 的活儿分出去一部分」的工具。
| Jev | 通用 LLM(Claude / ChatGPT / Gemini) | |
|---|---|---|
| 输出 | 类型固定的值+概率 | 文章(字符串) |
| 解析・校验 | 不需要 | JSON 模式下仍需要 |
| 响应时间 | 70〜500 毫秒 | 几秒到几十秒 |
| 输入单价(每百万) | $0.042 | $0.20〜$10 |
| 输出单价 | 免费 | 约为输入的 5 倍 |
| 擅长 | 分类、评分、真假判定 | 生成、长推理、对话 |
| 非英语 | 可接受,但准确率低于英语 | 达到实用水准 |
- Claude — 负责写文章与长推理;Jev 夹在它前后,承担护栏与输出验证。是组合关系而非竞争关系
- ChatGPT — 只做分类与抽取的话,也有 GPT-5.6 Luna(输入每百万 token 0.20 美元)这一选项。与 Jev 的差距约为 5 倍单价,加上输出是否计费、是否需要解析。已经在用 OpenAI 的话,先确认便宜模型够不够用
- Dify — 工作流条件分支上的 LLM 节点,正是「选项事先已定」的判断;换成 Jev 后这一步会从秒变成毫秒
- Claude Code — 装上官方 skill 后,可用于在仓库里找出脆弱的解析处理并改写成 Jev 调用
常见问题(FAQ)
QJev 可以免费使用吗
按量计费,但控制台账单页显示有每月 5 美元的免费额度(2026 年 9 月时点)。输入每百万 token 只要 0.042 美元,光这个额度就能试相当多次。使用前需要通过候补名单获得邀请。
Q能生成或摘要文本吗
不能。官方写明它没有接受过文本生成的训练。生成是 LLM 的工作,Jev 负责其前后的判断。
Q能传图片或 PDF 吗
不能。state 只支持文本,形式为字符串、JSON 对象、字符串数组三种。需要先经过 OCR 或转写。
Q「零幻觉」指的是什么
指的是类型不会坏:没定义过的标签不会出现,数值一定落在设定范围内。它并不意味着判断是对的。输出格式的保证与正确率是两回事。
Q从哪里开始试最快
从现在生产环境里交给 LLM 的处理中,挑一处需要把返回值当 JSON 解析的地方,把同样的输入取 10 条丢进 Playground,看判定是否一致。那里正是 Jev 的守备范围。
本页信息基于 2026 年 9 月 19 日时点 TypeSafe AI 官网、官方文档与官方博客公开的内容。Jev 处于早期访问阶段,规格、价格与速率限制可能变更。最新信息请以官网为准。