agent-qa
的使用方法、功能与可解决的业务课题
添加书签
agent-qa是什么?
agent-qa 是 vostride(版权人为个人 Pranshu Chittora)开发的 AI QA 智能体,可按自然语言编写的步骤运行 Web、Android、iOS 应用的端到端测试。它操作真实浏览器(Playwright)或真机与模拟器(Appium),并为每一步留下截图、日志、视频等证据。memidex 把在画面上得到证实的内容以文件形式保存在仓库中,供之后的运行使用。可通过 CLI、本地仪表盘,或经由 MCP 和技能从 Claude Code、Codex 使用。软件在 FSL-1.1-ALv2 的允许用途内免费,模型(API 或 Claude・Codex 订阅)费用另计。界面和文档仅有英文(截至 2026 年 11 月)。
可解决的业务课题
「agent-qa」的服务详情
agent-qa 是什么
agent-qa 是 vostride 开发的 AI QA 智能体,可按自然语言编写的步骤测试 Web、Android 和 iOS 应用。只要用句子描述用户的操作流程,例如"把杯子加入购物袋,并确认合计为 $36.00",agent-qa 就会在真实的浏览器或设备上执行这些步骤,把每一步与屏幕上显示的内容对照,判断是否通过。无需编写和维护选择器(指定页面元素的代码)。
每次运行后,名为 memidex 的机制会把在屏幕上得到证实的内容,以文件形式保存在代码仓库中,并把相关部分作为提示交给下一次运行。可以通过终端的 CLI、本地打开的仪表盘,或经由 MCP 和技能(Skills)从 Claude Code、Codex 等编程智能体使用。
软件采用 FSL-1.1-ALv2 许可,在允许的用途内可免费使用。用于测试判断的 AI 模型由用户自行准备,费用另计。界面和文档仅有英文,不支持日文显示(截至 2026 年 11 月)。官方 README 注明项目处于早期阶段,预计会有缺陷。
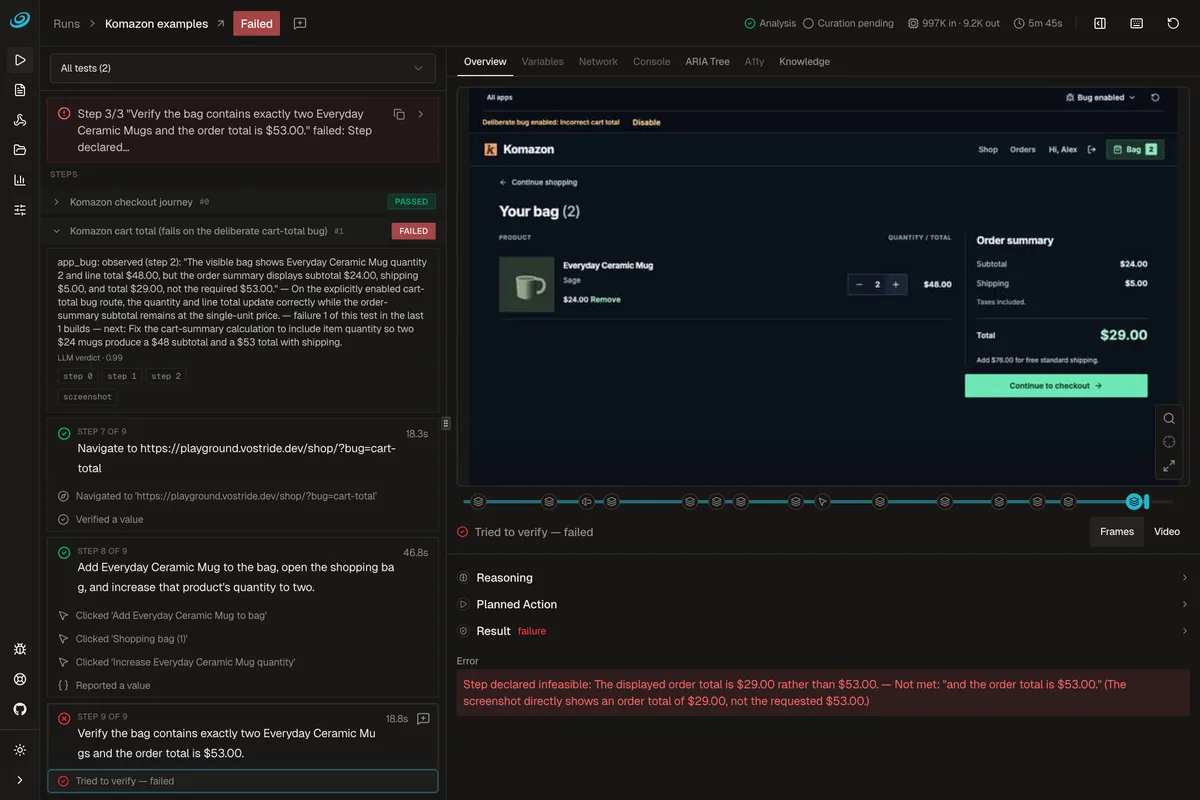
来源:agent-qa 的 GitHub 仓库(以下图片同)
使用方法
- 加入项目
需要 Node.js 24 及以上。在存放测试的文件夹(通常是应用仓库的根目录)运行
npm install -D agent-qa,再用npx agent-qa init生成配置文件(agent-qa.config.yaml)。使用 Claude 或 Codex 订阅时,还需安装登录用的@vostride/agent-qa-subscription-auth。 - 连接模型 登记 API 密钥,或在浏览器中登录 Claude、Codex 订阅。密钥不写入 YAML 等文件,而是用专用命令登记。
- 编写测试 一个测试由"目标应用"和"步骤列表"组成,写在 YAML 文件中。以"Verify""Check"开头的步骤是确认步骤,官方建议写明准确的值,例如写"合计为 $36.00"而不是"合计看起来正确"。也可以让编程智能体来写。
- 运行并查看证据
可通过
agent-qa run、仪表盘、编程智能体或 CI 运行。结果以合格与否和每一步的证据(看到了什么、做了什么、为何通过或失败)来确认。
官方快速入门提供了针对一个测试用小商店(其中一个页面故意埋了缺陷)运行示例测试的步骤,约 10 分钟即可完成。
写好步骤,就在真实画面上执行并留下证据
在 Web 上,agent-qa 通过 Playwright 操作真实浏览器;在移动端,通过 Appium 操作真机、模拟器(Android 用 UiAutomator2,iOS 用 XCUITest)。iOS 测试需要装有 Xcode 的 Mac 和模拟器,或连接的真机。也可以在 BrowserStack 的设备上运行。
自然语言步骤
- 目标应用
- 操作流程
- 要确认的值
在真实画面上操作
Web 用 Playwright,Android・iOS 用 Appium
每一步的证据
截图、控制台与网络日志、无障碍树、视频(Web 和 Android)
保存到 memidex
把在画面上证实的事实、注意事项和操作步骤,作为下次运行的提示
经模型判断而完成某一步的操作会被保存,下次同一步骤遇到同一画面时,不调用模型直接重放。配置、测试文字或画面任一发生变化,都会重新询问模型;重放失败的保存内容会被丢弃。官方称,在画面一致的重复运行中,这一缓存可减少约 60% 的 token,速度约快 5 倍(42 秒缩短到 8 秒)。
在终端运行时,会显示测试套件中每个测试的结果,以及在哪一步、哪里不一致。在官方演示中,下单流程的测试通过,而针对故意埋入的购物车合计缺陷的测试失败。
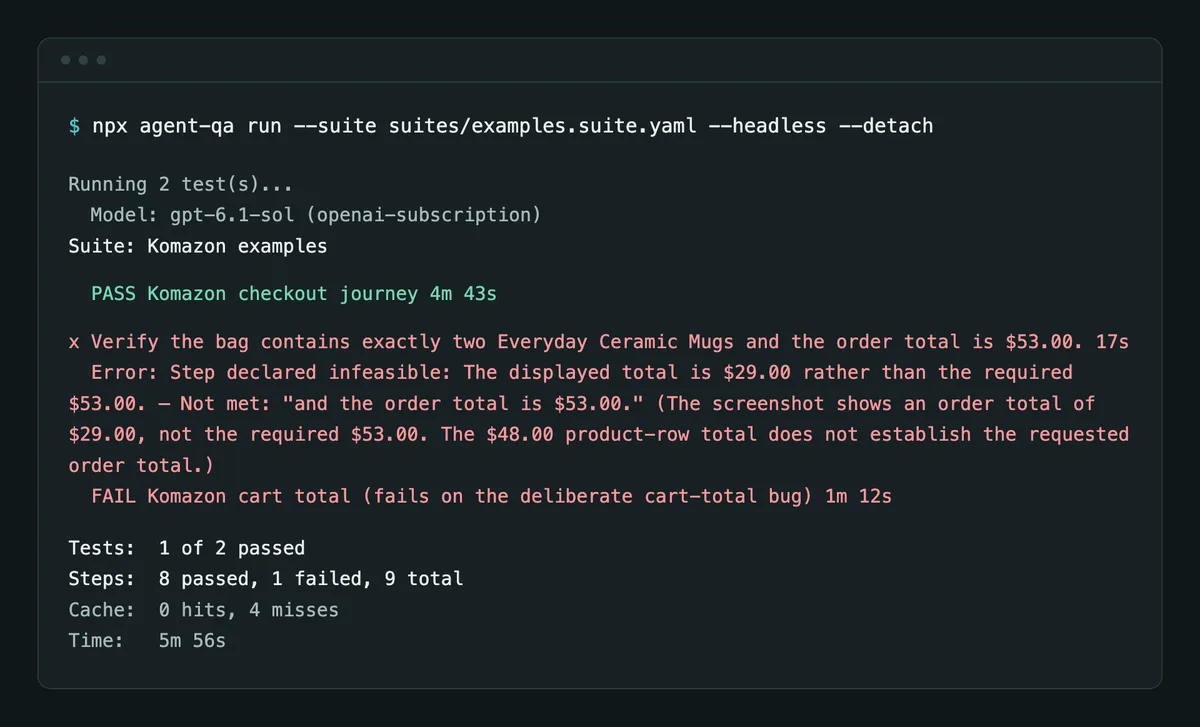
学到的内容先确认再使用,并以文件保存
agent-qa 的"自我改进"不会改写自身的提示词或代码。根据官方文档,它改进的是三样东西——关于应用的知识、无需模型即可重放的操作、可信赖的测试,流程如下:
- 运行:每一步都记录证据,合格与否和退出码在学习开始前就已确定
- 诊断:为每个失败区分原因,偶发失败或环境故障不会被当作关于应用的经验
- 学习:把运行中得到证实的内容变成 memidex 的候选(事实、注意事项、操作步骤)。措辞由模型撰写,允许什么由代码决定
- 确认:只有具备已验证步骤的确凿证据时,候选才会被采纳
- 纠正:判定有误时,给该次运行打标记(误判失败、误判通过、确认缺陷),agent-qa 会在同一次调用中修正背后的知识或测试
学到的内容以 agent-qa-knowledge/ 中的文件放在仓库里,可以用 git diff 审阅,也可以整批撤回。反复因不稳定原因失败的测试会被隔离(quarantine)。agent-qa 不会提交 git,CI 中的运行只提出候选,不会改变团队运行所信任的知识。
学习同样使用所配置的模型:对规则无法分类的失败进行分析、每个候选调用 1 次(每次运行最多 50 个)等,在得出结果后约 1 分钟内进行。
功能
01运行测试
把用句子写成的测试放到真实画面上执行。
- 支持的对象 — Web(Chromium 等浏览器)、Android、iOS
- 测试套件 — 可把一起运行的测试打包执行
- 钩子(Hooks) — 在测试前后运行准备或检查数据的脚本,在 Docker 容器中隔离执行(512MB、1 个 CPU、只读,默认无网络)
- 保存的登录 — 保存已登录状态并重复使用(仅限 Web)
- CI — 可在 CI 中运行并输出 JUnit 格式的结果
02与编程智能体协作
设计上设想让编程智能体验证自己的改动。
- MCP 服务器 — 可从 Claude Code、Codex 等 MCP 客户端编写测试、运行并读取证据
- 技能(Skills) — 可为智能体安装汇总了 agent-qa 用法的技能
- 安装用提示词 — 用一条提示词把从安装到首次运行测试的工作交给智能体
03模型的选择
在配置文件中切换模型,无需改写测试。
- 订阅 — 可登录 Claude(Claude Code)或 Codex 的订阅使用
- API — 用 API 密钥连接 OpenAI 兼容、Anthropic 兼容或 Gemini 端点
- 本地模型 — 通过 Ollama、LM Studio 等兼容端点使用本机模型
官方关于安全的说明
由于测试是借助模型操作真实应用,官方把 agent-qa 负责保护的部分和交给用户的部分分开说明。
基准测试结果
vostride 自行公布了两项衡量能否完成移动端任务的基准测试结果,并附有每项任务的证据。
| 基准测试 | 公布的结果 |
|---|---|
| AndroidWorld | 116 项任务全部成功(pass@1 100%)。与 2026 年 9 月 26 日的社区排行榜快照相比,称按 pass@1 并列第 1 |
| AppControlBench | iOS 60 分中得 60 分(完成率 100%),Android 55 分中得 54.5 分(完成率 99.1%) |
两者均为自行公布,AppControlBench 的结果并未登录官方排行榜。测试使用 gpt-6-sol,并关闭了 memidex 和自我改进。衡量的是移动端任务的完成情况,官方建议用户在自己的应用上评估 QA 判定的准确性(如误判通过的多少)。
价格
| 项目 | 费用 | 内容 |
|---|---|---|
| 软件(agent-qa) | 免费 | 在 FSL-1.1-ALv2 的"允许用途"内可使用、修改和再分发。没有付费方案 |
| AI 模型 | 用户承担 | API 按量费用,或 Claude、Codex 订阅。也可使用本地模型 |
| 运行环境 | 用户承担 | 运行测试的机器与设备、CI、BrowserStack 等 |
- FSL-1.1-ALv2 不是开源许可。源代码公开,除"竞争性用途"(在竞争性的商业产品或服务中把该软件提供给他人)外均可使用。每个版本在发布两年后也可按 Apache License 2.0 使用
- 学习(自我改进)和编写测试时也会调用所配置的模型
(截至 2026 年 11 月,依据官方许可页面和文档)
与其他 AI 测试・编程工具的区别
| 产品 | 测试方式 | 特点 |
|---|---|---|
| agent-qa | 在真实画面(Web、Android、iOS)上执行用自然语言写的用户操作流程 | 每一步的证据、memidex 记忆,可经 MCP 从 Claude Code、Codex 使用。软件免费 |
| Tusk | 根据拉取请求的改动生成单元测试、集成测试代码并在 CI 中运行 | 与 GitHub 联动,帮助提高覆盖率并检测回归 |
| Claude Code | 按指示编写测试代码并用命令运行 | 承担从实现到发布的编程智能体。包含在 Claude 的 Pro/Max/Ultra 中 |
| Codex | 按指示编写并运行测试代码 | OpenAI 的编程智能体,可通过 ChatGPT 方案使用 |
| Devin | 在专用环境中自主完成规划、实现、测试和创建拉取请求 | 支持多仓库、并行会话的自主型 AI 工程师 |
表中其他产品的内容为各产品页面所记载的确认时点的内容。
想在代码层面增加测试,可以考虑 Tusk;想把包括测试在内的实现本身交出去,可以考虑 Claude Code、Codex、Devin,或在编辑器中运行的 Cline。agent-qa 适合承担用与用户相同的画面操作来确认这些智能体所做改动的角色。
常见问题
Q. agent-qa 可以免费使用吗? 软件免费,没有付费方案。但用于测试判断的 AI 模型费用(API 按量费用,或 Claude、Codex 订阅)以及运行测试的环境费用需另外承担。
Q. 它是开源的吗? 源代码在 GitHub 上公开,但许可为 FSL-1.1-ALv2,并非开源许可。除作为竞争性商业产品或服务提供给他人外均可使用。每个版本在发布两年后也可按 Apache License 2.0 使用。
Q. 可以用日文使用吗? 界面、文档和测试示例均为英文,不支持日文显示(截至 2026 年 11 月)。
Q. 测试 iOS 应用需要什么? 除 Appium 和 XCUITest 驱动外,还需要装有 Xcode 的 Mac 和模拟器,或连接的真机。也可以在 BrowserStack 的设备上运行。
Q. 如何从 Claude Code 或 Codex 使用? 登记 agent-qa 的 MCP 服务器并安装技能后,智能体即可编写测试、运行并读取证据。v0.2 中 MCP 调用没有审批确认,官方建议像交出 shell 一样谨慎交出。
提供方
agent-qa 由 vostride 开发。许可中的版权声明为个人(Pranshu Chittora)名义,未记载运营法人。源代码在 GitHub(vostride/agent-qa)、软件包在 npm(agent-qa)公开,联系地址为 hello@vostride.com。
本页信息基于截至 2026 年 11 月官方网站、文档和 GitHub 上公开的内容。功能和许可条件可能变更,最新信息请以官方网站为准。