ランクレート
Runcrate
の使い方・機能・解決する業務課題
ブックマークする
Runcrate(ランクレート)とは?
Aeonmind LLCが提供する、AI開発者とAIエージェント向けのGPUクラウド。H100・A100・RTX 4090など20機種のGPUを時間単位(多くは秒単位の課金)で借りられ、223のモデルをOpenAI互換の推論APIで呼べる。MCPサーバーでClaude Code・Codex・CursorからGPUを起動でき、前払い残高からの従量課金(20ドルから、月額料金なし)。
解決する業務課題
「Runcrate」のサービス詳細
Runcrateとは
Runcrate(ランクレート)は、Aeonmind LLC が提供するAI開発者とAIエージェント向けのGPUクラウドです。H100・A100・L40S・RTX 4090 など20機種のGPUを時間単位で借りられる「インスタンス」と、223のモデルをOpenAI互換のAPIで呼べる「推論API」を、1つのアカウント・1つの前払い残高で使えます。
特徴は、人だけでなくAIエージェントが使うことを前提に作られている点です。Claude Code・Codex・Cursor などにMCPサーバーを1行で追加すると、エージェントが自分でGPUを起動し、学習や推論のコマンドを実行して、終わったらマシンを止めます。コマンドが終わるとマシンと課金が一緒に止まる「ジョブ」や、環境ごとの月間予算など、止め忘れ・使いすぎを防ぐ仕組みがそろっています。
2026年10月21日時点
テキスト・画像・動画・音声
起動中は課金されない
月額料金・最低利用額なし
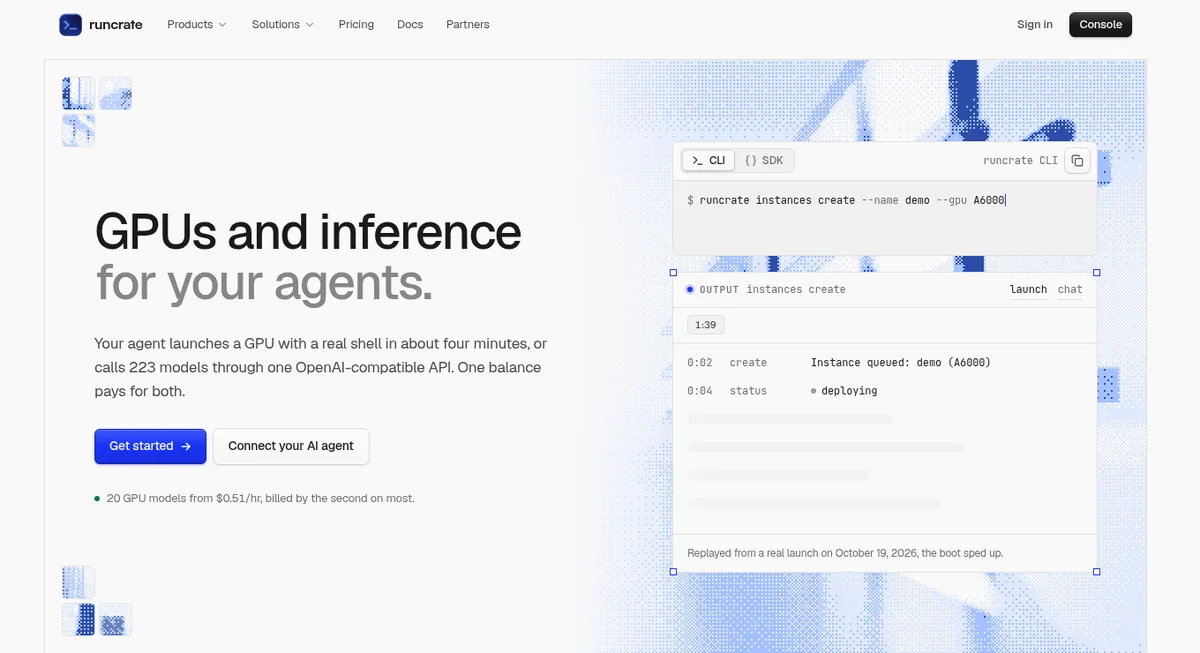
出典: Runcrate 公式サイト(以下の画面画像も同様)
料金
月額料金はなく、前払いの残高(クレジット)から使った分だけ差し引かれます。1クレジットは1米ドルで、チャージは20ドルからです。GPU・推論API・ストレージのすべてを同じ残高で支払います。
GPUの時間単価は、在庫と提供元によって変わる「その時点の最安値」です。2026年10月21日に料金ページとGPU料金API(/api/gpu-pricing、5分ごとに更新)で確認した、1GPU・1時間あたりの最安値は次のとおりです。同じ日のうちにも動いており、たとえばH100 SXMは確認したタイミングによって3.25ドル・3.38ドル・3.55ドルでした。借りられる枚数も在庫によって変わります(同じ日のうちに、RTX 4090 は1枚・8枚から8枚のみに、H100 SXM は1・2・8枚から1・2・4・8枚に変わりました)。
| GPU | メモリ | 1時間あたり(最安値) | 1台で借りられる枚数 |
|---|---|---|---|
| V100 16GB | 16GB | 0.51ドル | 1・2・4枚 |
| RTX 4090 | 24GB | 0.52ドル | 1・8枚 |
| RTX A6000 | 48GB | 0.65ドル | 1・2・4枚 |
| L40S | 48GB | 1.14ドル | 1・2・4・8枚 |
| A100 80GB | 80GB | 1.76ドル | 1・2・4・8枚 |
| RTX PRO 6000 | 96GB | 2.54ドル | 1・2・8枚 |
| H100 SXM | 80GB | 3.25ドル | 1・2・8枚 |
| H200 | 141GB | 4.24ドル(分単位課金) | 1・2・4・8枚 |
| B200 | 180GB | 12.35ドル | 8枚 |
| B300 | 288GB | 14.30ドル | 8枚 |
- 支払いはクレジットカード・デビットカード(Visa・Mastercard・American Express)で、決済には Stripe を使っています
- 残高が設定額を下回ったら自動でチャージする「オートリチャージ」があります。残高が0になると、借金を防ぐため稼働中のインスタンスは自動で削除されます(ストレージはすぐには消えませんが、アクセスできなくなります)
- データ転送(エグレス)の料金はかかりません。まとめてチャージしても割引はありません
- 利用に使ったクレジットは返金されません
出典: 料金ページ・Billing FAQ・Credits・Payment Methods・General FAQ
使い方
-
アカウントを作り、クレジットをチャージする
ダッシュボードの「Billing」から20ドル以上をチャージします。残高はワークスペースごとに分かれていて、請求の設定を触れるのはOwnerとManagerだけです。
-
使う入り口を選ぶ
ブラウザのコンソール、CLI(
brew install aeonmindai/tap/runcrateなど)、Python・TypeScript のSDK、REST API、MCPサーバーのどれからでも同じ操作ができます。 -
GPUを起動する、またはモデルを呼ぶ
GPUはインスタンスとして起動し、SSH・Jupyter・ブラウザ上のVS Codeで作業します。推論APIは、OpenAIのSDKの
base_urlをhttps://api.runcrate.ai/v1に変えるだけで既存のコードがそのまま動きます。 -
止め忘れを防ぐ設定をする
インスタンスには「最大実行時間」(5分〜7日)と「アイドル停止」(5分〜24時間)を設定できます。決まったコマンドを走らせるだけなら、終わると自動で止まる「ジョブ」を使います。
-
ファイルはボリュームに残す
インスタンスを削除するとローカルのディスクも消えます。データセットやチェックポイントはストレージのボリュームに置けば、次に起動したインスタンスにそのまま付け替えられます。
エージェントに頼むと、GPUを借りて返すところまでやる
Runcrate がほかのGPUクラウドといちばん違うのは、AIエージェントからの利用を正面から設計している点です。公式のMCPサーバー(https://mcp.runcrate.ai/mcp)はOAuthでサインインするので、設定ファイルにAPIキーを貼る必要がありません。Claude Code なら次の1行で追加できます。
claude mcp add --transport http --scope user runcrate https://mcp.runcrate.ai/mcp
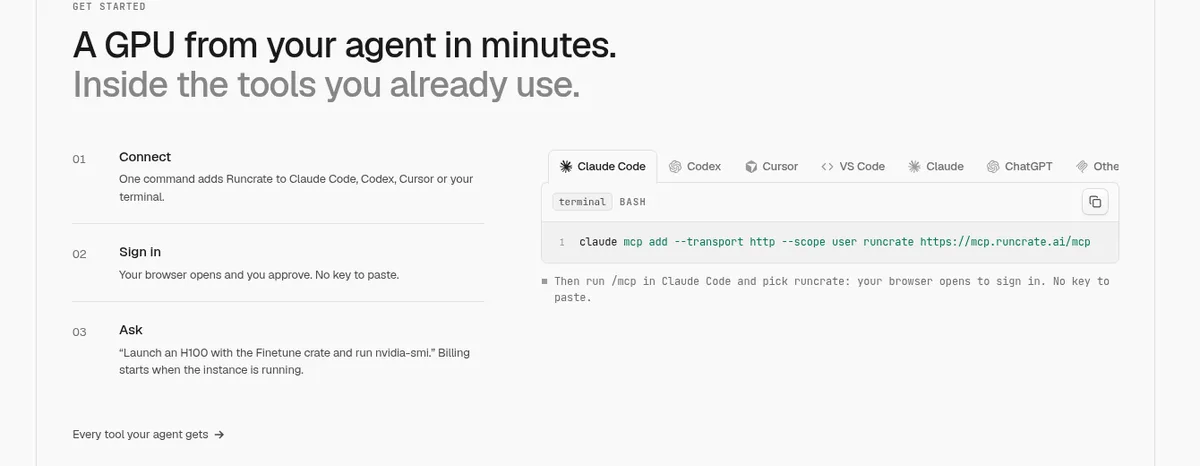
つないだあとは、「A4000で python train.py を最大2時間で実行して、ボリューム training-data を使って、終わったら最後の loss を教えて」のように普通の言葉で頼みます。公式ドキュメントによると、エージェントは次の順にツールを呼びます。
ボリュームを探す
list_volumes で training-data のIDを調べる
ジョブを投げる
run_job でGPU・コマンド・最大実行時間・ボリュームを指定し、新しいマシンで実行
ログを追う
get_job_logs で出力を読み続け、必要なら途中で止める
結果を返す
get_job で終了コードと費用を確かめて答える。マシンはもう止まっている
ジョブはコマンドが終わる・最大実行時間に達する・キャンセルされると、マシンも課金も止まる
エージェントに任せたときの使いすぎ対策も用意されています。サインイン時にエージェントが作業する「環境」を選び、その環境に月間予算をかけると、エージェントは環境を切り替えたり予算を引き上げたりできません。最大実行時間やアイドル停止が働く10分前には、メールとWebhookで知らせが届きます。
出典: AI agents・Jobs・Spend guardrails
機能
01GPUを借りる
学習・ファインチューニング・モデルの配信など、GPUそのものが必要な作業のための機能です。
- インスタンス — 名前を付けたGPUマシンを時間単位で借りる。SSH・Jupyter・ブラウザ上のVS Codeが使える
- Crates — Devbox・Finetune・Inference など、作業に必要なツールを入れた起動イメージ。インスタンス代以外の料金はかからない
- ジョブ — 1つのコマンドを専用のマシンで実行し、終わったらマシンを止める。複数のGPUを順に試す・失敗したら作り直して再実行する・同じジョブを並べて実行する、といった指定もできる
- スケジュール — cronのように決まった時刻にジョブを走らせる
- 予約クラスタ — 8GPU以上・複数ノード・1か月以上の利用向け。InfiniBandでつないだベアメタルのクラスタを見積もりで用意する
02モデルを呼ぶ
自分でGPUを立てずに、用意されたモデルをAPIで使うための機能です。
- 推論API — チャット・画像生成・動画生成・音声合成・文字起こし・埋め込みを、OpenAI互換のエンドポイントで呼ぶ。2026年10月21日時点のモデル数は223(テキスト141・画像31・動画26・画像理解16・音声合成6・文字起こし3)
- 扱うモデルの例 — DeepSeek・Qwen・Llama・Kimi・GLM・Mistral などのオープンモデルに加え、Claude、FLUX、Sora 2・Veo・Kling などの動画モデル、Whisper
- Playground — ブラウザでモデルを試す
03チームで安全に使う
複数人・複数のエージェントで使うときの管理機能です。
- ワークスペースと権限 — Owner・Manager・Developer の3つの役割。Developer はリソースを扱えるが、請求とチームの設定には触れない
- 監査ログ — 誰が・いつ・どのIPから・何を変えたかを記録する
- Webhook — 起動・停止・予算などのイベントを、Slack・Discord などへ送る
- ストレージ — ボリュームは保存時に暗号化され、ワークスペースの外からは見えない。ファイルエクスプローラー付き
起動にかかる時間は、実測値を公開している
公式サイトでは、2026年9月19日〜10月18日の30日間に16機種で行われた449回の起動をもとに、起動の依頼から稼働までの時間を公開しています。中央値は4分14秒で、速い1割は2分55秒以内、遅い1割は6分50秒を超えました。機種別の中央値は、RTX PRO 6000が2分59秒、H200が3分09秒、H100 SXMが4分14秒、A100 80GBが5分35秒などです。この待ち時間には課金されず、課金はインスタンスが稼働を始めた時点から始まります。
出典: Runcrate 公式サイト(2026年10月19日の計測として掲載)
メリット・デメリット
メリット
- 月額料金・最低利用額がなく、20ドルのチャージから使える
- 多くのGPUが秒単位の課金で、起動中の時間は課金されない
- GPUと推論APIとストレージを、1つの残高・1つのダッシュボードで管理できる
- 推論APIがOpenAI互換で、既存のコードの
base_urlを変えるだけで移れる - MCPサーバーがOAuth対応で、Claude Code・Codex・Cursor から1行でつなげる
- ジョブ・最大実行時間・アイドル停止・月間予算で、止め忘れと使いすぎを防げる
- エグレス料金がかからない
デメリット
- 画面・ドキュメントは英語のみ(日本語の紹介記事は運営チームがZennに出している)
- GPUのリージョンは在庫によって変わり、選べるとは限らない。2026年10月21日にGPU料金APIで確認した時点では、日本(東京)で借りられるのはH200だけだった
- 無料枠がない。最初に20ドルのチャージが必要
- GPUの単価は在庫に応じて変わり、同じ日でも動く
- 残高が0になると稼働中のインスタンスは自動で削除されるため、長い処理ではオートリチャージの設定が要る
- B200・B300 は8枚単位での提供
評判・口コミ
公式サイトには利用者の声は掲載されていません(2026年10月時点)。トップページには「Teams at these organizations use Runcrate」として利用組織のロゴが並んでいます。
運営チームは、日本の開発者向けにZennで「Claude Code から GPU を借りて学習ジョブを回す(Runcrate MCP サーバー)」という記事を2026年10月21日に公開し、MCPサーバーのつなぎ方・ジョブの投げ方・CLIと推論APIの使い方を日本語で説明しています。質問やフィードバックは hello@runcrate.ai かDiscordで受け付けています。
Hugging Face・Ollamaとの違い
Runcrate は「GPUを時間で借りる」と「モデルをAPIで呼ぶ」の両方を、同じ残高で扱えるのが特徴です。オープンモデルを使う方法は大きく3つあり、それぞれ向いている場面が違います。
| 方法 | どこで動くか | 向いている場面 |
|---|---|---|
| Runcrate | クラウドのGPU/推論API | 手元にGPUがなく、学習・ファインチューニングから推論の呼び出しまで、エージェントにも任せたい |
| Hugging Face | モデルの公開・共有の場(推論や計算資源も提供) | モデル・データセットを探す、比べる、公開する |
| Ollama | 自分のPC | 手元のマシンでオープンモデルを無料で動かしたい |
AIエージェントから使う場面では、Claude Code・Codex・Cursor がコードを書き、Runcrate がそのコードを走らせるGPUを用意する、という分担になります。
よくある質問(FAQ)
Q. Runcrateは無料で使えますか?
A. 無料枠はありません。前払いのクレジット制で、20ドルからチャージできます。月額料金や最低利用額はありません。
Q. GPUの料金はいくらですか?
A. 2026年10月21日時点の最安値は、V100 16GBが1時間0.51ドル、RTX 4090が0.52ドル、A100 80GBが1.76ドル、H100 SXMが3.25ドル前後です。価格は在庫に応じて変わるため、最新の値は料金ページかGPU料金APIで確かめてください。
Q. 起動に失敗したときや、起動を待っている間も課金されますか?
A. 起動中は課金されません。課金はインスタンスが稼働を始めた時点から始まり、多くのGPUは秒単位、一部は分単位(削除後の約30秒の後処理を含む)で計算されます。
Q. 日本語に対応していますか?
A. 画面とドキュメントは英語です。推論APIで呼ぶモデル自体は日本語を扱えるものが多く、Zennの公式記事では日本語のプロンプトで呼ぶ例が紹介されています。
Q. OpenAIのSDKはそのまま使えますか?
A. 使えます。base_url を https://api.runcrate.ai/v1 に、APIキーをRuncrateのものに替えれば、PythonでもTypeScriptでも既存のコードが動きます。
Q. エージェントが勝手にGPUを使いすぎることはありませんか?
A. エージェントはサインイン時に承認した環境の中だけで動き、その環境の月間予算を超えて使うことはできません。ジョブには最大実行時間が必須で、インスタンスにも最大実行時間とアイドル停止を設定できます。
Q. データはどう守られていますか?
A. 公式のSecurity FAQによると、インスタンスは分離されたコンテナで動き、ストレージのボリュームは保存時に暗号化されます。カード情報は Stripe が扱い、Runcrate は保持しません。
出典: General FAQ・Billing FAQ・Security FAQ・Zenn の公式記事
本ページの情報は2026年10月時点で公式サイトに公開されている内容にもとづきます。GPUの単価は随時変わります。最新の仕様・料金は公式サイトをご確認ください。