エージェントキューエー
agent-qa
の使い方・機能・解決する業務課題
ブックマークする
agent-qa(エージェントキューエー)とは?
agent-qa(エージェントキューエー)は、vostride(著作権者は個人の Pranshu Chittora)が開発する、Web・Android・iOS アプリのE2Eテストを自然言語の手順で実行するAIのQAエージェント。実際のブラウザ(Playwright)や端末・エミュレーター(Appium)を操作し、手順ごとにスクリーンショット・ログ・動画などの証拠を残す。画面で確かめられたことを memidex がリポジトリ内のファイルとして記憶し、次の実行に生かす。CLI・ローカルのダッシュボード・MCP とスキルで Claude Code や Codex からも使える。ソフトウェアは FSL-1.1-ALv2 の許可された用途で無料、モデル(API や Claude・Codex のサブスクリプション)の費用は別途。画面と資料は英語のみ(2026年11月時点)。
解決する業務課題
「agent-qa」のサービス詳細
agent-qaとは
agent-qa(エージェントキューエー)は、vostride が開発する、Web・Android・iOS アプリのテストを自然言語の手順で実行するAIのQAエージェントです。「商品をカートに入れ、合計が $36.00 になっていることを確かめる」のように利用者の操作の流れを文章で書くと、実際のブラウザや端末でその手順を操作し、画面に出ている内容と照らして合否を判定します。セレクター(画面の部品を指定するコード)を書いて保守する必要はありません。
実行のたびに、画面で確かめられたことを memidex(メミデックス)という仕組みがリポジトリ内のファイルとして記憶し、次の実行に手がかりとして渡します。ターミナルの CLI、手元で開くダッシュボード、MCP とスキルを通じた Claude Code・Codex などのコーディングエージェントから使えます。
ソフトウェアは FSL-1.1-ALv2 というライセンスで、許可された用途なら無料で使えます。テストの判断に使うAIモデルは利用者が用意し、その費用は別にかかります。画面とドキュメントは英語のみで、日本語の表示には対応していません(2026年11月時点)。公式の README は「初期段階で、不具合が見込まれる」と明記しています。
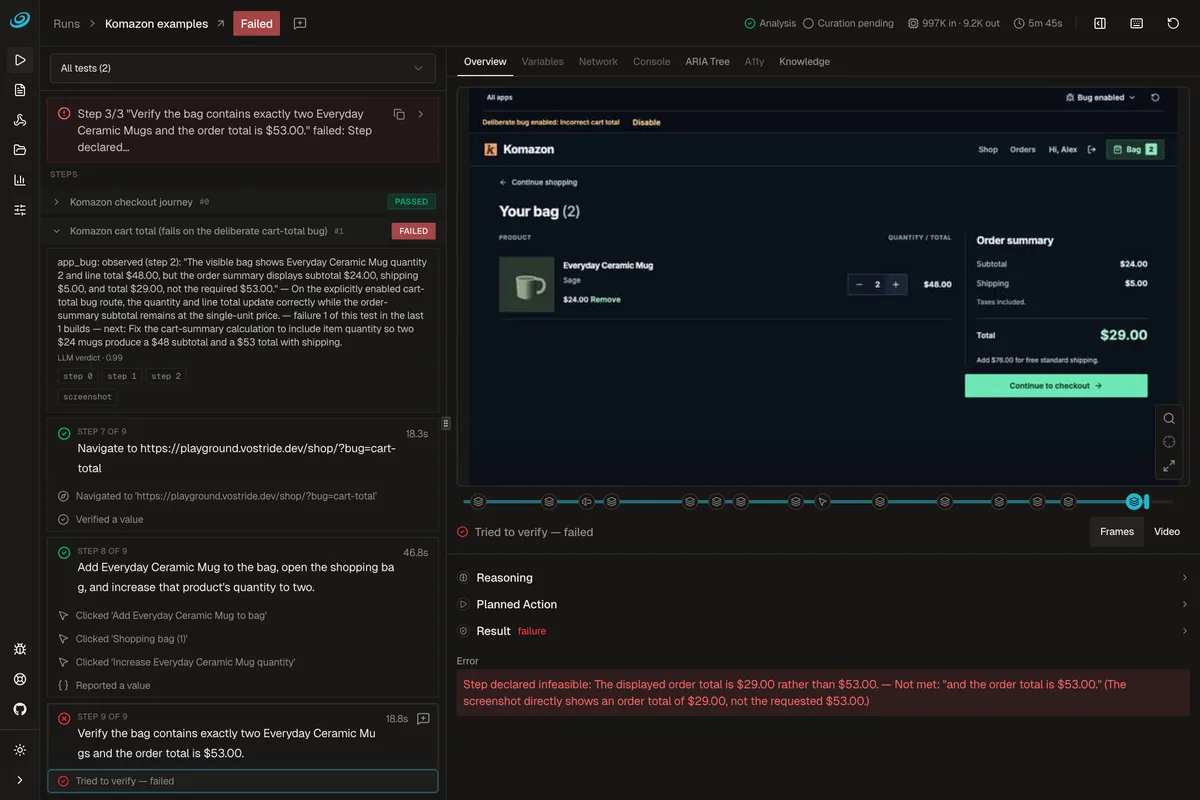
出典: agent-qa の GitHub リポジトリ(以下の画像も同様)
使い方
- プロジェクトに入れる
Node.js 24 以上が必要です。テストを置くフォルダ(通常はアプリのリポジトリの直下)で
npm install -D agent-qaを実行し、npx agent-qa initで設定ファイル(agent-qa.config.yaml)を作ります。Claude や Codex のサブスクリプションで使う場合は、サインイン用の@vostride/agent-qa-subscription-authも入れます。 - モデルをつなぐ API キーを登録するか、Claude・Codex のサブスクリプションにブラウザでサインインします。キーは YAML などに書かず、専用のコマンドで登録します。
- テストを書く 1つのテストは「対象のアプリ」と「手順の一覧」で、YAML のファイルに書きます。「Verify」「Check」で始まる手順が確認の手順になり、「合計が正しく見える」ではなく「合計が $36.00 である」のように正確な値を書くよう公式は案内しています。コーディングエージェントに書かせることもできます。
- 実行して証拠を見る
agent-qa runやダッシュボード、コーディングエージェント、CI から実行します。結果は合否と、各手順の証拠(何を見て、何をして、なぜ合格・不合格になったか)で確かめます。
公式のクイックスタートには、テスト用に用意された小さなショップ(わざと不具合を仕込んだページがある)に対して、例のテストを約10分で動かす手順があります。
手順を書けば、実画面で動かして証拠を残す
agent-qa は Web では Playwright で実際のブラウザを、モバイルでは Appium で実機やエミュレーター・シミュレーター(Android は UiAutomator2、iOS は XCUITest)を操作します。iOS のテストには Xcode の入った Mac とシミュレーター、または接続した実機が必要です。BrowserStack 上の端末でも実行できます。
自然言語の手順
- 対象のアプリ
- 操作の流れ
- 確かめる値
実画面で操作
Web は Playwright、Android・iOS は Appium で実際の画面を動かす
手順ごとの証拠
スクリーンショット、コンソールとネットワークのログ、アクセシビリティツリー、動画(Web と Android)
memidex に記憶
画面で確かめられた事実・注意点・手順を、次の実行の手がかりにする
一度モデルの判断で通った操作は保存され、同じ手順が同じ画面に出会ったときはモデルを呼ばずに再生されます。設定・テストの文面・画面のどれかが変わるとモデルに聞き直し、再生に失敗した保存分は捨てられます。公式は、画面が一致したくり返しの実行では、このキャッシュでトークンが約60%減り、約5倍速くなる(42秒が8秒に)と説明しています。
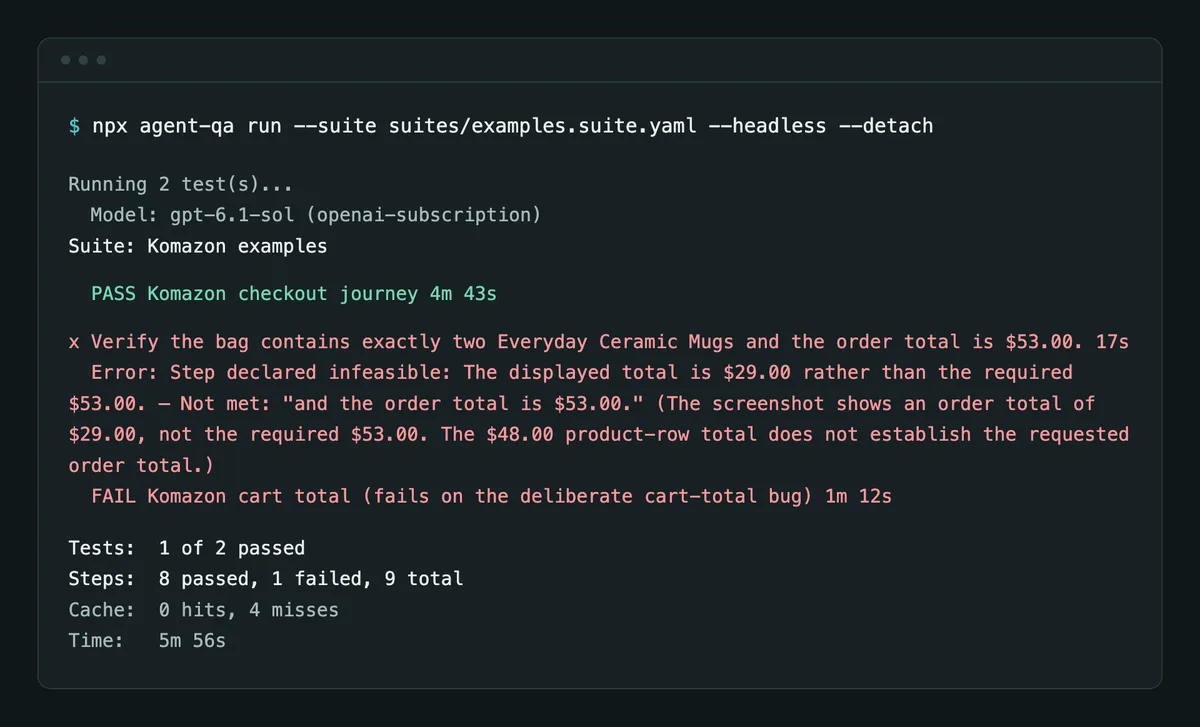
ターミナルから実行すると、スイートのテストごとに合否と、どの手順で、何が食い違ったかが表示されます。公式のデモでは、注文の流れのテストが合格し、カートの合計にわざと仕込んだ不具合のテストが不合格になっています。
学んだことは、確かめてから使い、ファイルで残す
agent-qa の「自己改善」は、自分のプロンプトやコードを書き換えるものではありません。公式のドキュメントによると、改善するのは「アプリについての知識」「モデルなしで再生できる操作」「信頼できるテスト」の3つで、その流れは次のとおりです。
- 実行:各手順が証拠を残し、合否と終了コードは学習の前に確定する
- 診断:失敗ごとに原因を分け、たまたま落ちた失敗や環境の不具合は、アプリについての教訓として扱わない
- 学習:実行で確かめられたことを、memidex の候補(事実・注意点・手順)にする。文面はモデルが書き、何を許すかはコードが決める
- 確認:候補が採用されるのは、確かめられた手順の証拠がそろったときだけ
- 訂正:判定が間違っていたら、実行に印を付ける(誤った不合格・誤った合格・本当の不具合)。agent-qa はその判定のもとになった知識かテストを、同じ操作で直す
学んだ内容は agent-qa-knowledge/ のファイルとしてリポジトリに置かれ、git diff で見直したり、まとめて取り消したりできます。くり返し不安定に落ちるテストは隔離(quarantine)されます。agent-qa が git にコミットすることはなく、CI での実行は候補を出すだけで知識を変えません。
学習にも設定したモデルを使います。規則で分類できない失敗の分析、候補1件につき1回(1回の実行で最大50件)の呼び出しなどが、合否が出たあとの1分ほどの間に行われます。
機能
01テストの実行
手順を文章で書いたテストを、実際の画面で動かします。
- 対応する対象 — Web(Chromium などのブラウザ)、Android、iOS
- スイート — いっしょに流すテストをまとめて実行できる
- フック — テストの前後にデータの準備や確認のスクリプトを走らせる。Docker のコンテナ(512MB・1CPU・読み取り専用、既定でネットワークなし)で隔離して動く
- 保存したログイン — ログイン済みの状態を保存して使い回せる(Web のみ)
- CI — CI で実行し、JUnit 形式の結果を出せる
02コーディングエージェントとの連携
コーディングエージェントに、変更の検証をさせる使い方を想定しています。
- MCP サーバー — Claude Code・Codex などの MCP クライアントから、テストを書く・実行する・証拠を読む
- スキル — agent-qa の使い方をまとめたスキルをエージェントに入れられる
- セットアップ用のプロンプト — 導入からはじめのテストの実行までを、1つのプロンプトでエージェントに任せられる
03モデルの選び方
モデルは設定ファイルで切り替え、テストは書き直しません。
- サブスクリプション — Claude(Claude Code)や Codex のサブスクリプションでサインインして使える
- API — OpenAI 互換・Anthropic 互換・Gemini のエンドポイントに API キーでつなぐ
- ローカルモデル — Ollama・LM Studio などの互換エンドポイントで、手元のモデルも使える
安全面で、公式が説明していること
テストはモデルを介して実際のアプリを操作するため、公式は何を守り、何を利用者に任せるかを分けて書いています。
ベンチマークの結果
vostride は、モバイルのタスクを完了できるかを測る2つのベンチマークの結果を、タスクごとの証拠とともに自社で公開しています。
| ベンチマーク | 公表されている結果 |
|---|---|
| AndroidWorld | 116タスクすべてで成功(pass@1 100%)。2026年9月26日時点のコミュニティのリーダーボードと比べて、pass@1 で同率1位としている |
| AppControlBench | iOS は60点中60点(完了率100%)、Android は55点中54.5点(完了率99.1%) |
どちらも自社による公表で、AppControlBench の結果は公式のリーダーボードへの登録ではありません。計測は gpt-6-sol を使い、memidex と自己改善を切った状態で行われています。モバイルのタスクを完了できるかの測定で、QA としての判定の正しさ(誤った合格の少なさなど)は自分のアプリで確かめるよう公式は案内しています。
料金
| 項目 | 費用 | 内容 |
|---|---|---|
| ソフトウェア(agent-qa) | 無料 | FSL-1.1-ALv2 の「許可された用途」で利用・改変・再配布できる。有料プランはない |
| AIモデル | 利用者が負担 | API の従量料金、または Claude・Codex のサブスクリプション。ローカルモデルも可 |
| 実行環境 | 利用者が負担 | テストを動かすマシン・端末、CI、BrowserStack など |
- FSL-1.1-ALv2 はオープンソースのライセンスではなく、ソースを公開したうえで「競合する用途」(このソフトウェアを他者に提供する、競合する商用の製品・サービス)を除いて使えるライセンスです。各版は公開から2年たつと Apache License 2.0 でも使えるようになります
- 学習(自己改善)やテストの作成でも、設定したモデルを呼び出します
(2026年11月時点、公式サイトのライセンスのページとドキュメントによる)
他のAIテスト・コーディングツールとの違い
| 製品 | テストのしかた | 特徴 |
|---|---|---|
| agent-qa | 自然言語で書いた利用者の操作の流れを、実際の画面(Web・Android・iOS)で動かす | 手順ごとの証拠、memidex による記憶、MCP で Claude Code・Codex から使える。ソフトウェアは無料 |
| Tusk | プルリクエストの変更から単体テスト・統合テストのコードを生成し、CI で実行する | GitHub と連携し、カバレッジの向上とリグレッションの検知を支援 |
| Claude Code | 指示に応じてテストコードを書き、コマンドで実行する | 実装からリリースまでを担うコーディングエージェント。Claude の Pro/Max/Ultra に含まれる |
| Codex | 指示に応じてテストコードを書き、実行する | OpenAI のコーディングエージェント。ChatGPT のプランで使える |
| Devin | 計画・実装・テスト・プルリクエストの作成までを専用環境で自律的に進める | 複数リポジトリ・並列セッションに対応する自律型のAIエンジニア |
比較表の他製品の内容は、各製品ページに記載の確認時点の内容です。
コードの単位でテストを増やしたいなら Tusk、テストを含む実装そのものを任せたいなら Claude Code・Codex・Devin や、エディタの中で動く Cline が候補になります。agent-qa は、それらのエージェントが作った変更を、利用者と同じ画面の操作で確かめる役割に向いています。
よくある質問
Q. agent-qaは無料で使えますか。 ソフトウェアは無料で、有料プランはありません。ただし、テストの判断に使うAIモデルの費用(API の従量料金、または Claude・Codex のサブスクリプション)と、テストを動かす環境の費用は別にかかります。
Q. オープンソースですか。 ソースは GitHub で公開されていますが、ライセンスは FSL-1.1-ALv2 で、オープンソースのライセンスではありません。競合する商用の製品・サービスとして他者に提供する用途を除いて使えます。各版は公開から2年後に Apache License 2.0 でも使えるようになります。
Q. 日本語で使えますか。 画面・ドキュメント・テストの例はすべて英語です。日本語の表示には対応していません(2026年11月時点)。
Q. iOS アプリのテストに何が必要ですか。 Appium と XCUITest のドライバーに加えて、Xcode の入った Mac とシミュレーター、または接続した実機が必要です。BrowserStack 上の端末でも実行できます。
Q. Claude Code や Codex からどう使いますか。 agent-qa の MCP サーバーを登録し、スキルを入れると、エージェントがテストを書き、実行し、証拠を読めるようになります。v0.2 では MCP の呼び出しに承認の確認がないため、公式はシェルを渡すのと同じつもりで渡すよう説明しています。
提供元
agent-qa は vostride が開発しています。ライセンスの著作権表示は個人(Pranshu Chittora)の名義で、運営法人の記載はありません。ソースは GitHub(vostride/agent-qa)、パッケージは npm(agent-qa)で公開されており、連絡先は hello@vostride.com です。
本ページの情報は2026年11月時点で公式サイト・ドキュメント・GitHub に公開されている内容にもとづきます。機能・ライセンスの条件は変更されることがあるため、最新の情報は公式サイトをご確認ください。