Jevとは【2026年9月最新】文章を生成しないAI「System Oneモデル」の使い方・料金・活用事例
2026年9月15日、2年間のステルス期間を経たTypeSafe AIが4,000万ドルの調達とともに公開した Jev(ジェヴ)が、SNSだけでなくQiita・Zennでも話題になっています(Qiitaは9月16日〜10月2日に公式イベントを開催)。話題の理由はベンチマークよりも「文章を生成しないAI」という位置づけの分かりやすさです。Jevはチャットせず、あらかじめ定義した選択肢から1つを確率つきで返します。この記事では、Choice(分類)・Score(採点)・Noul(0〜1の真偽)という3つの質問型で実際に何が返るのか、質問をいくつ積んでも応答時間が変わらない投機的ファンアウト、入力100万トークン$0.042で出力が無料という価格設計、ウェイトリスト登録からPython SDK・HTTP API・Claude Codeスキルまでの使い方、confidenceをしきい値にして人に回す設計、問い合わせ振り分け・LLMガードレール・RAG再ランキングといった活用事例を整理します。あわせて、公式が「日本語を含むCJKは精度が英語より低い」と明記している点と、公式が自ら公開している弱点(数を数えられない・日付の比較が弱い等)も扱います。
2026年9月15日、ステルス状態だったスタートアップTypeSafe AIが4,000万ドルの調達とともに姿を現し、最初のモデルJev(ジェヴ)を早期アクセスで公開しました。翌日にはThe Registerが「人間ではなく機械と話すためのモデル」として報じ、XやBlueskyで拡散。QiitaとZennにも検証記事が並び、Qiitaは9月16日から10月2日まで公式イベント「あなたはもう試した?判断特化AI『Jev』で遊ぼう!」を開催しています。
話題になっている理由は、ベンチマークの数字よりも「文章を生成しないAI」という位置づけの分かりやすさにあります。Jevはチャットしません。プロンプトに文章で答えるのではなく、こちらがあらかじめ定義した選択肢の中から1つを、確率つきで返します。返ってくるのは "technical"、1.6、0.92 といった、そのまま if に入れられる値です。
この記事では、Jevが実際に何を返すのか、3つの質問型(Choice・Score・Noul)の使い分け、料金と速度、早期アクセスの取り方から最初のリクエストまで、そして日本語で使うときの注意点を、TypeSafe AIの公式ドキュメント・公式ブログと、日本のエンジニアによる検証記事にもとづいて整理します。
結論|先に3行で
Jevは「System Oneモデル」という新しい種類のAIで、文章を書きません。状態(テキストまたはJSON)と型の決まった質問を渡すと、Choice(分類)・Score(採点)・Noul(0〜1の真偽)を確率つきで返します。文字列が生成されないので、パースする対象も、検証して弾く対象もありません。
速くて安い。公式の数字で応答70〜500ms、入力100万トークンあたり$0.042、出力トークンは無料です。質問は並列に評価されるため、1回の呼び出しに質問を10個積んでも応答時間はほとんど変わりません。ここがLLMと決定的に違う設計です。
ただし公式ドキュメントは「日本語を含むCJKは受け付けるが、現時点では精度が落ちる」と明記しています。英語が第一言語のモデルです。日本語で本番投入するなら、自社データでconfidenceのしきい値を決める工程を省けません。
なぜ今、Jevがこれだけ話題なのか
1週間のあいだに3つのことが重なりました。
ステルス解除と同時公開
- TypeSafe AIが4,000万ドルの調達を発表(DCVC主導)
- Forbesは評価額を約2億ドルと報道
- Jevを早期アクセスで公開
Doomを遊ぶデモが拡散
- The Registerが報道
- 毎秒約10回の呼び出しでDoomのボットを操作
- コストは1時間あたり約7ドル
日本の技術コミュニティへ
- Qiita公式イベント(〜10月2日)
- Zennに検証スクラップ・解説記事
- 「文章を生成しないAI」という表現で拡散
Doomのデモについては、担当エンジニア自身が「AIを使わないDoomボットのほうがうまく遊べる」と認めています。速さと安さを示すための実演であって、性能の主張ではありません。
注目すべきなのは、話題の中心が「LLMを置き換える」ではなく「LLMに投げていた判断を、LLMの外に出す」である点です。分類・優先度づけ・ガードレール判定といった処理を、これまでは仕方なくGPTやClaudeに投げてJSONで返させ、壊れたJSONをリトライで拾っていました。Jevはそこだけを担当します。
公式公表値
出力トークンは無料
stateは32kまで
DCVC主導・2026年9月
Jevとは|「System Oneモデル」という新しい分類
TypeSafe AIはJevをSystem Oneモデルという新しいモデルクラスの第1弾として出しています。名前はダニエル・カーネマンの『ファスト&スロー』に由来します。
- System 1 — 速く、自動的で、直感的な思考。顔を見て感情を読む、文の調子で怒っていると分かる
- System 2 — 遅く、意識的で、手順を踏む思考。桁の多い掛け算、設計の検討
現在のLLMは、チェーン・オブ・ソートも含めてSystem 2寄りに作られています。ところが実際の業務システムが必要としている判断の大半は、「このチケットはどの部署か」「この文は緊急か」のようなSystem 1の仕事です。そこに毎回System 2の機械を持ち出していたのが、これまでの構成でした。
モデル名のJevは、経済学者ウィリアム・スタンレー・ジェヴォンズから取られています。「効率が上がると、かえって総需要が増える」というジェヴォンズのパラドックスで知られる人物で、判断が安く速くなれば判断の回数そのものが爆発的に増える、という見立てが込められています。
LLMに判断させるのと、何が違うのか
LLMに分類させる従来の構成
- 返ってくるのは文字列。JSONモードでも検証が要る
- 知らないラベルを勝手に作ることがある
- 確率が出ないので、迷っているかどうか分からない
- 逐次サンプリングなので数秒〜数十秒
- 質問を増やすとそのぶん遅く、高くなる
Jevに判断させる構成
- 返ってくるのは型の決まった値。パース不要
- 選択肢は定義した集合の外に出ない
- 全選択肢の確率分布とconfidenceが返る
- 並列評価なので70〜500ms
- 質問を増やしても応答時間はほぼ変わらない
公式の比較表を数字で並べると次のようになります。LLM側の単価は各社の一般的なレンジです。
| 観点 | 汎用LLM | Jev |
|---|---|---|
| 出力の形 | 文章(文字列) | 型の決まった値+確率 |
| パース・検証 | JSONモードでも必要 | 不要 |
| サンプリング | 逐次 | 並列 |
| 応答時間 | 3〜329秒 | 70〜500ms |
| 入力単価(100万トークン) | $0.20〜$10 | $0.042 |
| 出力単価 | 入力の約5倍 | 無料 |
| 得意な仕事 | 生成・長い推論・対話 | 分類・採点・真偽判定 |
「ハルシネーション0%」の意味に注意してください。公式が言っているのは型が壊れないことです。定義していないラベルは出てこないし、数値は必ず定義した範囲に収まります。しかし判断そのものが正しいとは言っていません。Qiitaの検証記事でも「型が守られていても、入力の意味を誤って判断する可能性は残ります」と指摘されています。出力形式の保証と正答率は別の話です。
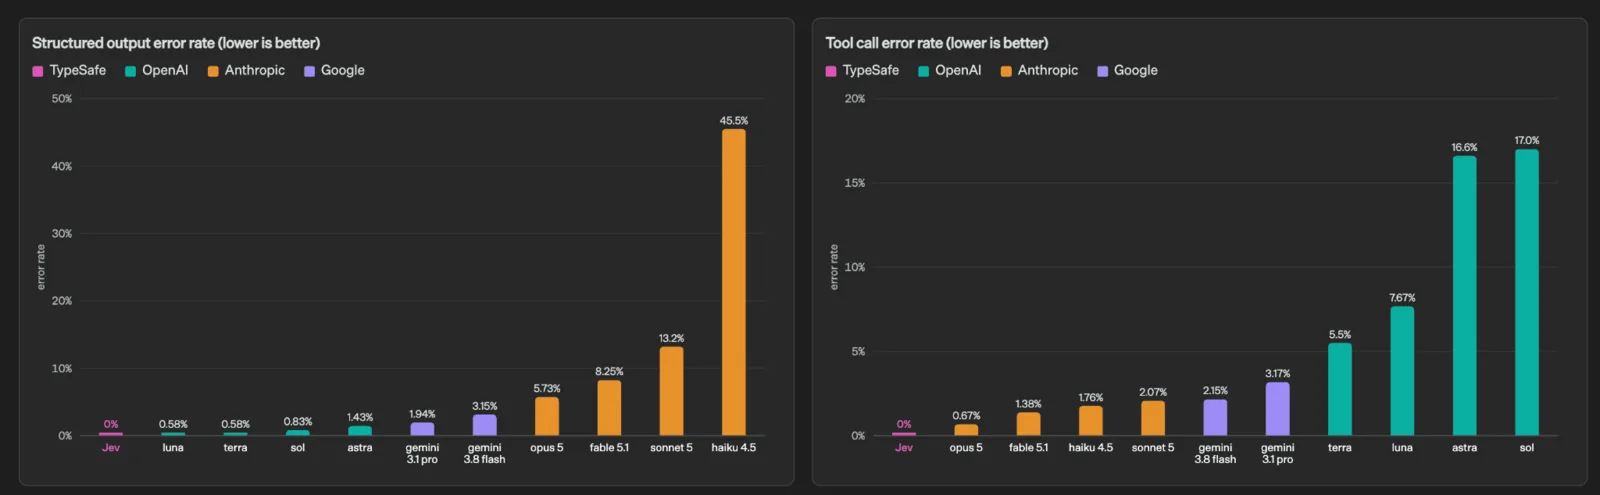
型が壊れた割合の比較(左が構造化出力、右がツール呼び出し。いずれも低いほど良い)。出典: TypeSafe AI 公式ブログ
公式が公開しているのがこの2つのグラフです。構造化出力のエラー率はJevが0%、GPT-5.6 Lunaが0.58%、Claude Haiku 4.5が45.5%。ツール呼び出しのエラー率はJevが0%、Claude Opus 5が0.67%、GPT-5.6 Solが17.0%。ここで測っているのは「指定した型どおりに返ってきたか」であって、判断が当たったかではありません。JSONモードを使っていてもリトライ処理が消せない理由が、この数字に出ています。
何が返ってくるのか|Choice・Score・Noulの3つだけ
Jevに投げられる質問は3種類しかありません。この制約がそのまま、型が壊れない理由になっています。
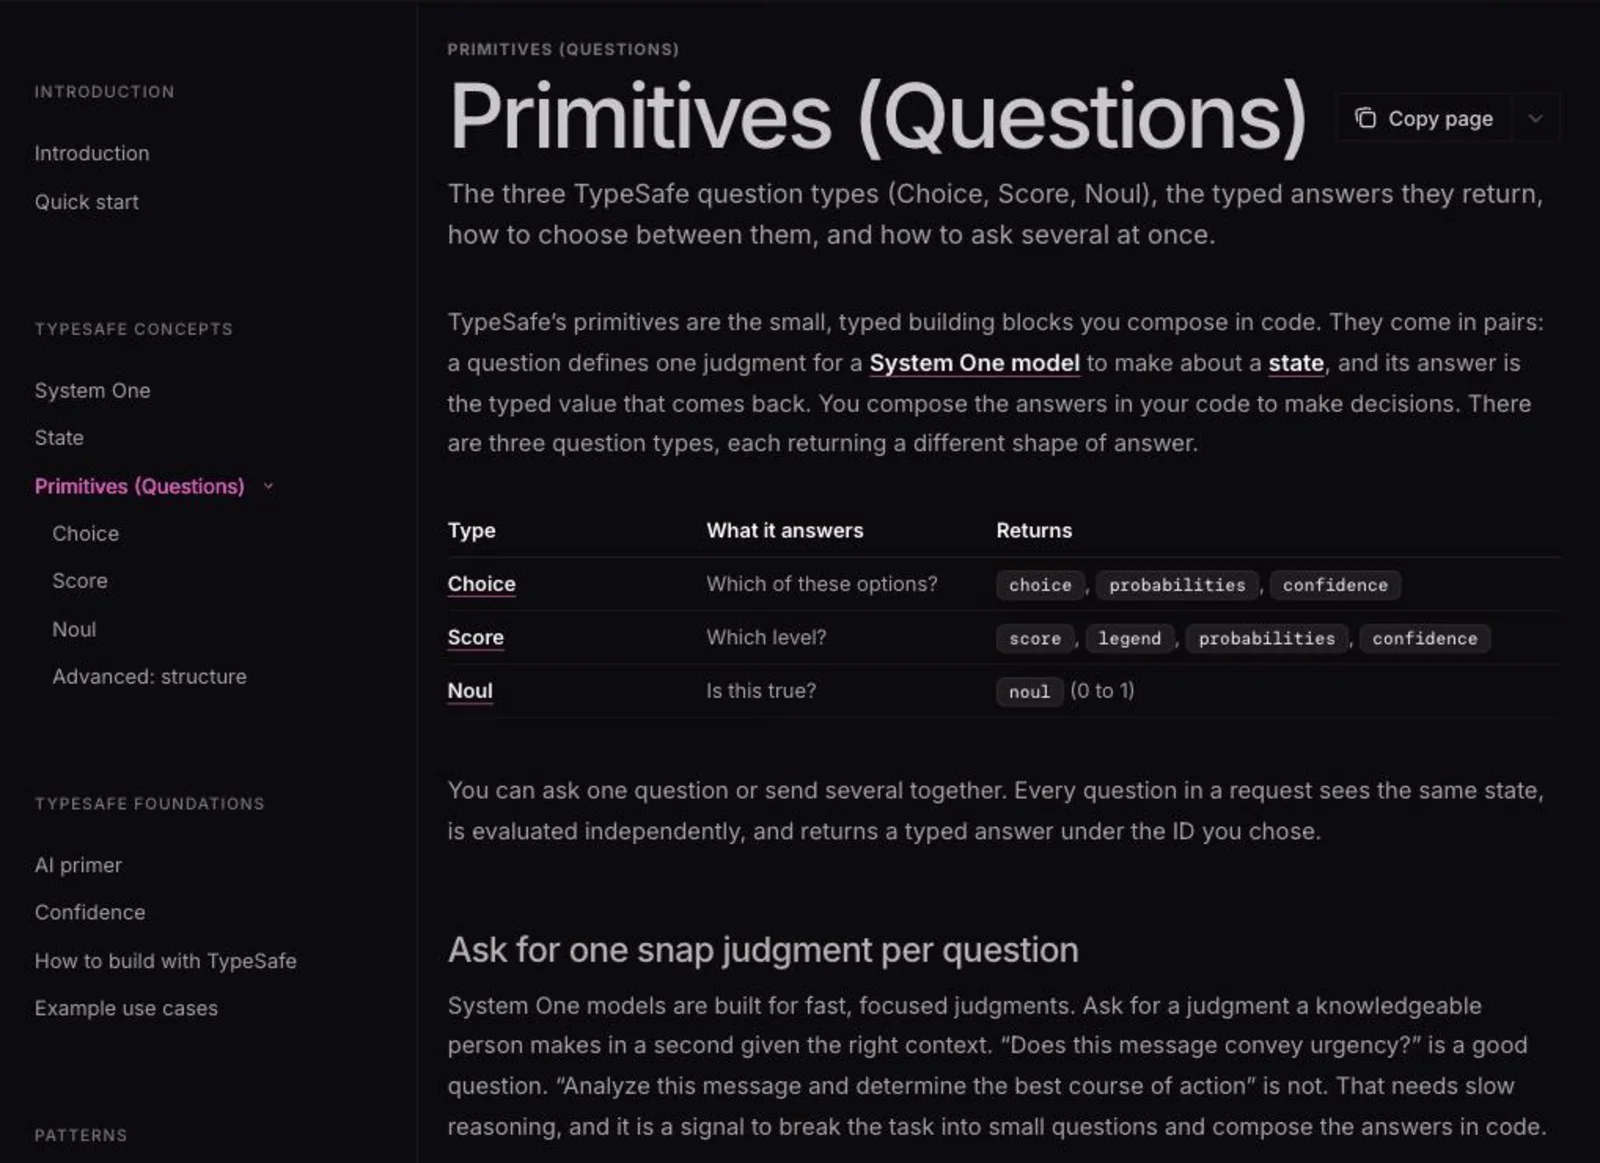
公式ドキュメントの Primitives ページ。左のナビゲーションに Choice・Score・Noul と Confidence・Patterns が並ぶ。出典: TypeSafe AI 公式ドキュメント
Choice|決まった選択肢から1つ選ぶ
順序のない分類です。チケットの振り分け先、文書の種別、言語判定などに使います。
Choice(
    instructions="Which team should handle this",
    criteria={
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions",
    },
)
返るのは choice(選ばれたキー)、probabilities(全選択肢の確率分布)、confidence(分布がどれだけ1つに尖っているか)の3つです。公式は、想定外の入力が来うるなら other や none of the above を選択肢に入れておくよう勧めています。
Score|順序のある段階で採点する
段階に意味がある尺度です。バグの深刻度、顧客の苛立ち、スキルの習熟度など。
Score(
    instructions="How frustrated the customer appears",
    criteria=[
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language",
    ],
)
返る score は 1.6 のように段階のあいだの値を取ります。「1と2の中間」という状態をそのまま表現できるのがScoreの特徴です。legend(段階の対応表)、probabilities、confidence も同時に返ります。
Noul|「その文は真か」を0〜1で返す
Jev独自の型です。真偽を尋ねますが、返るのは true/false ではなく0〜1の確率です。
Noul(
    instructions="The message conveys urgency or time-sensitivity",
)
1に近ければ強い「はい」、0に近ければ強い「いいえ」、0.5付近は「判断がつかない」。Noulには別途のconfidenceがありません。確率そのものが確信度を表しているためです。
公式が注意しているのは、ScoreとNoulを取り違えないことです。「スキルが中程度」を表したいときにNoulで0.5を返させてはいけません。それは「中程度だ」ではなく「はいかいいえか分からない」という意味になります。
質問は、いくつ積んでも遅くならない
Jevで一番効くのがここです。1回のリクエストに入れた質問はすべて並列に評価されるため、公式ドキュメントは「質問を追加しても応答時間は通常まったく増えない」と書いています。
そこから生まれるのが投機的ファンアウトという書き方です。分岐した先でしか使わない質問も、最初からまとめて投げてしまいます。
response = client.system_one(
    state=ticket,
    questions={
        "category": Choice(...),        # 常に使う
        "bug_severity": Score(...),     # バグだったときだけ使う
        "has_repro": Noul(...),         # バグだったときだけ使う
        "refund_requested": Noul(...),  # 課金だったときだけ使う
        "frustration": Score(...),      # 常に使う
    },
)
チケットが機能要望だった場合、bug_severity の結果は使いません。それでも構いません。LLMなら「分類してから、結果を見てもう一度聞く」という往復が発生するところを、1往復で済ませられます。
料金と速度|出力が無料という価格設計
2026年9月時点で公開されているモデルは Jev 1.13 の1つです。
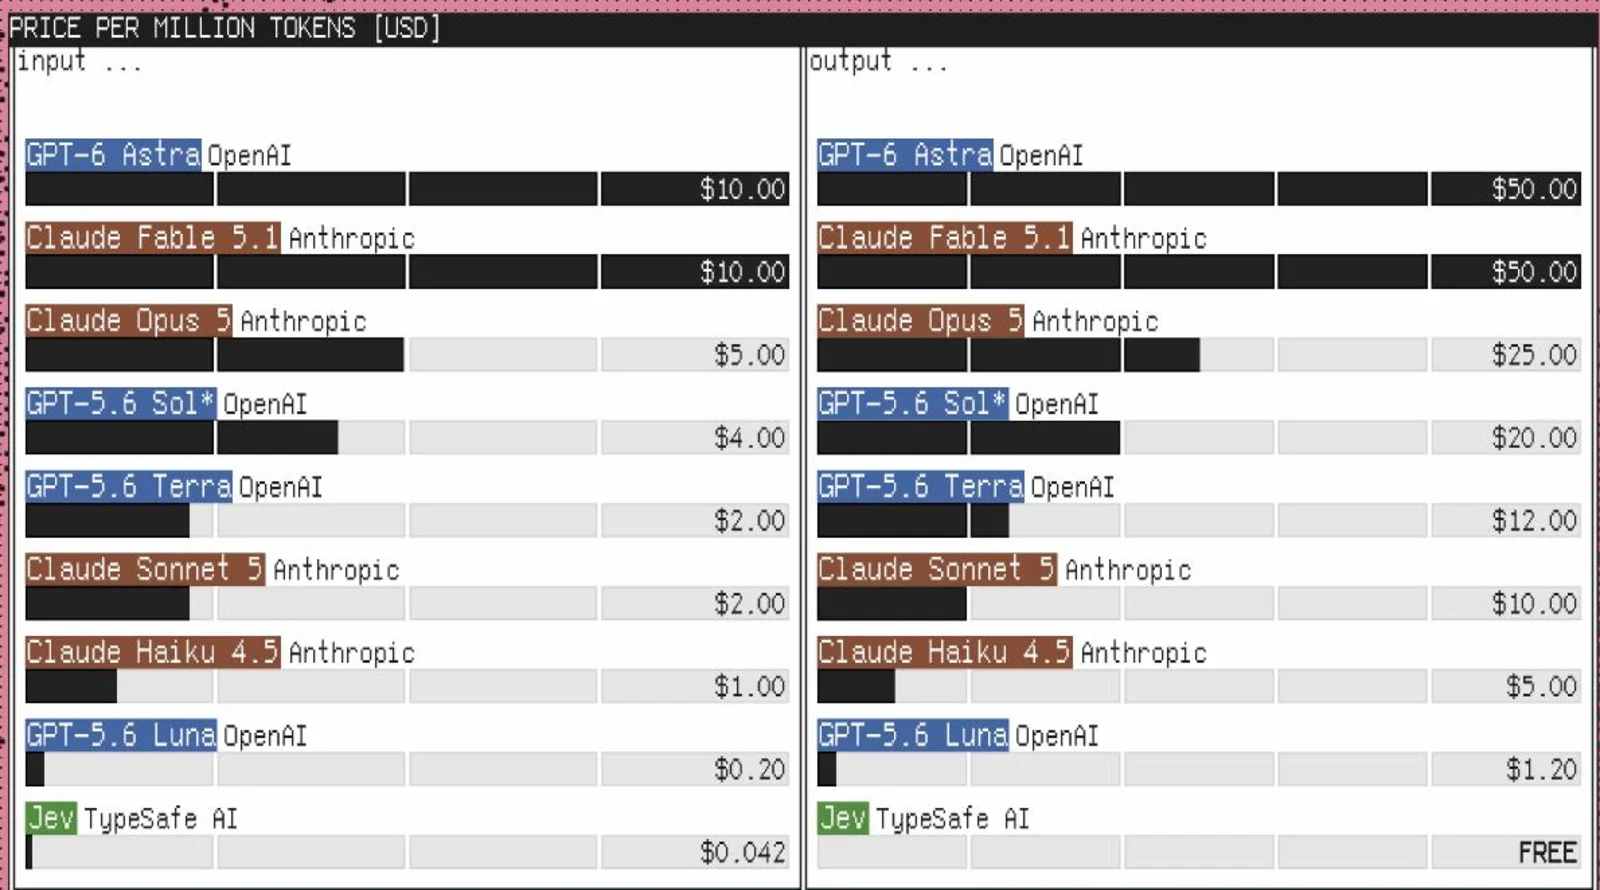
公式サイトが掲げる価格比較。右列の出力単価で、Jev だけが FREE になっている。出典: TypeSafe AI 公式サイト
公式サイトは「Claude Fable 5.1より入力単価が238分の1」「System Oneワークフローで193.6倍速く、444.6倍安い」と掲げています。
この数字は自社評価です。TypeSafe AIは、正解ラベルつきの既存ベンチマークではなく「ワークフローevals」という独自の評価枠組みを作り、GPT-6 AstraとFable 5.1の予測を参照確率として比較しています。ベンチマーク名も4つのワークフローの中身も公開されていません。第三者による検証はまだ出ていないため、採用を決める前に自分のデータで測ることが前提になります。
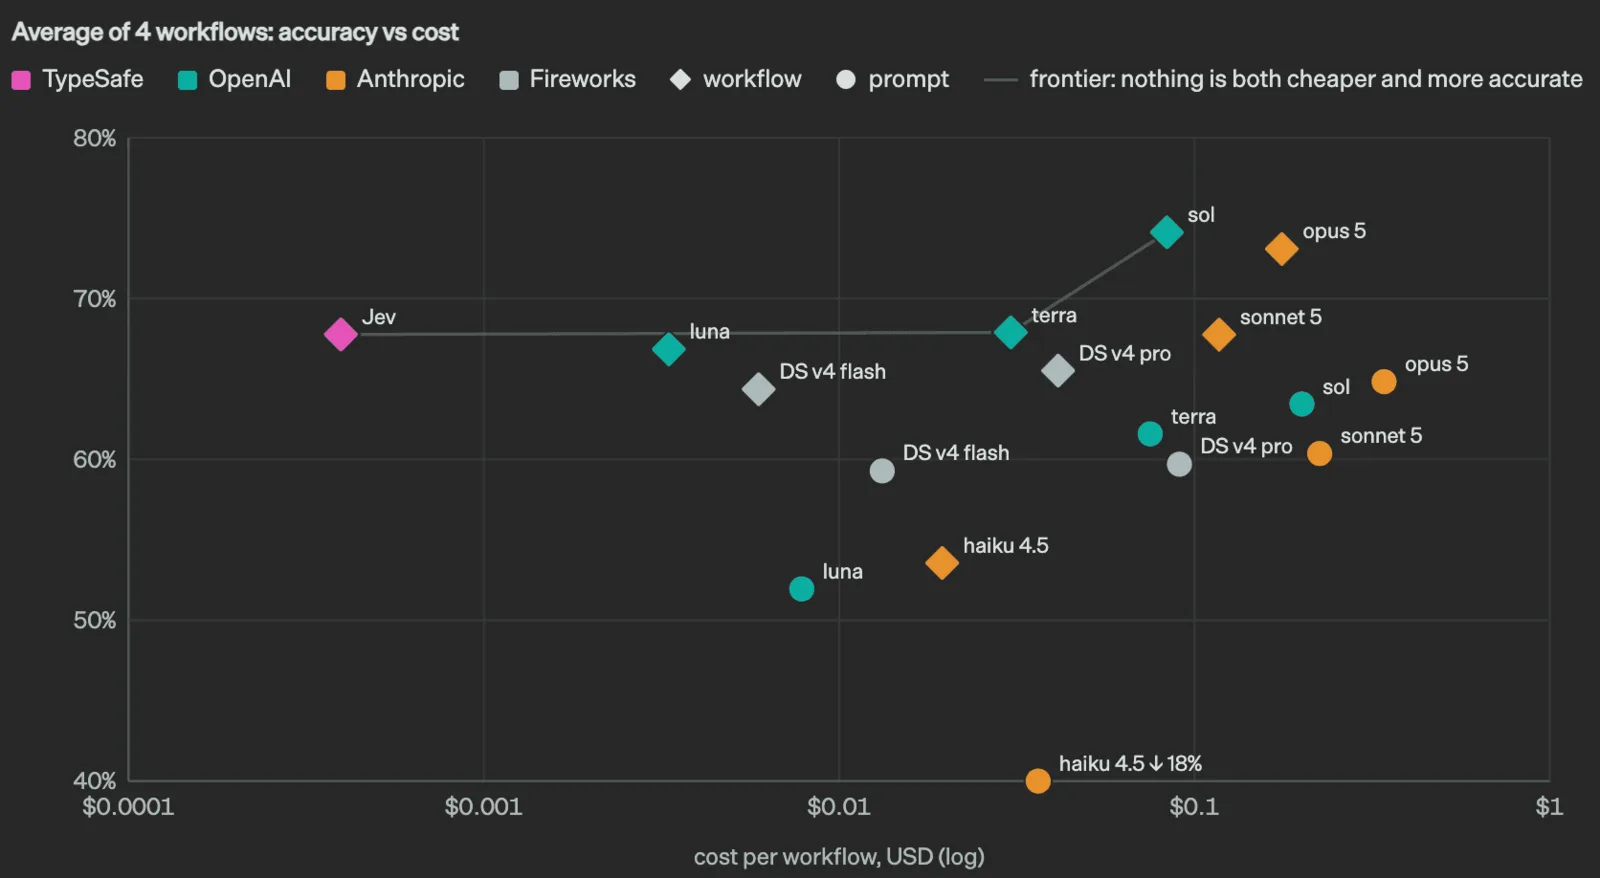
精度とコストの関係。横軸は1ワークフローあたりの費用(対数)。出典: TypeSafe AI 公式ブログ
このグラフが、数字の並びより正確に立ち位置を伝えています。Jevは最高精度のモデルではありません。4つのワークフロー平均の精度は約68%で、GPT-5.6 Solの約74%に6ポイント届いていません。Jevがいるのは「同じくらいの精度を、2桁安く出す」位置です。GPT-5.6 Lunaが約$0.003で約67%、Terraが約$0.04で約68%。Jevはほぼ同じ精度を約$0.0004で出しています。
したがって判断の分かれ目は「Jevが賢いか」ではなく、その処理に6ポイントの精度差を払う価値があるかです。誤りを人が拾える設計(confidenceで回す)になっていれば安いほうが効き、1件の取りこぼしが高くつく処理ならSolのままのほうが安全です。
それでも、桁が2つ違う価格差は無視できません。たとえば1日10万件のチケットを分類する場合、1件あたり400トークンなら入力は1日4,000万トークン。Jevなら1日$1.68、出力は無料です。同じ処理を入力$2.00/出力$12.00のモデルでやれば、出力を1件50トークンとしても1日$140前後になります。
使い方|登録から最初のリクエストまで
-
早期アクセスに登録する
typesafe.ai からウェイトリストに登録します。2026年9月時点では「できるだけ速くウェイトリストから順に案内している」という状態で、日本のエンジニアの報告では登録後まもなく案内メールが届き、コンソールに入れています。
-
APIキーを発行する
console.typesafe.ai でアカウントを作り、APIキーを発行します。キーは発行時の1回しか表示されません。その場で控えてください。環境変数名は
TYPESAFE_API_KEYです。 -
Playgroundで感触をつかむ
コンソールのPlaygroundは、左にstate(プレーンテキスト)、右にquestions(JSON)を書く画面です。実測のレイテンシも表示されます。日本語のチケット文で「このメッセージは緊急性を表していますか?」というNoulを投げて0.98が返った、という検証報告が出ています。SDKを入れる前に、ここで質問文を詰めるのが早道です。
-
Python SDKから呼ぶ
pip install typesafe-sdkfrom typesafe_sdk import Choice, Noul, Score, TypeSafeClient client = TypeSafeClient() ticket = "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP." response = client.system_one( state=ticket, questions={ "department": Choice( instructions="Which team should handle this", criteria={ "billing": "Payment or subscription issues", "technical": "Bugs or integration problems", "sales": "Pricing or account questions", }, ), "frustration": Score( instructions="How frustrated the customer appears", criteria=[ "Calm, just stating facts", "Frustrated but civil", "Very angry, strong language", ], ), "is_urgent": Noul( instructions="The message conveys urgency or time-sensitivity", ), }, ) print(response.answers["department"].choice) # "billing" print(response.answers["frustration"].score) # 1.035 print(response.answers["is_urgent"].noul) # 0.999JavaScript/TypeScriptの場合は
npm install @typesafe-ai/sdk(Node.js 20以降)。client.systemOne()を呼ぶと、質問定義から戻り値の型が推論されます。 -
HTTP APIを直接叩く
SDKを使わない場合は
POST https://api.typesafe.ai/v1/systemoneに投げます。認証はAuthorization: Bearer <API_KEY>です。{ "state": "Help! My payouts have been failing for 3 days.", "model": "jev-latest", "questions": { "is_urgent": { "type": "noul", "instructions": "Does this convey urgency?" }, "department": { "type": "choice", "instructions": "Which team should handle this?", "criteria": { "billing": "Payments, invoicing, refunds", "technical": "Bugs, outages, integrations", "sales": "Pricing, upgrades, new accounts" } } } }返りはこうなります。
usageに入力・出力トークン数が入りますが、課金対象は入力だけです。{ "model": "jev-latest", "answers": { "is_urgent": { "type": "noul", "noul": 0.92 }, "department": { "type": "choice", "choice": "technical", "probabilities": { "billing": 0.08, "technical": 0.85, "sales": 0.07 }, "confidence": 0.82 } }, "usage": { "input_tokens": 312, "output_tokens": 48 } } -
コーディングエージェントから使う
公式がエージェント向けのスキルを配布しています。Claude Codeなら次の2行です。
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
他のエージェントは
npx skills add typesafe-ai/skills --skill typesafe-ai。3つの質問型と設計パターンの知識が入るので、既存コードの中で「壊れやすいパース処理をしている箇所」を見つけて置き換える、という使い方ができます。ただし公式自身が「エージェントは質問文を書くのが得意ではないので、一緒に直す前提で」と書いています。質問文の設計は人の仕事です。
confidence|「自信がない」を受け取って人に回す
LLMに「確信度も返して」と頼んでも、返ってくるのは自己申告の作文です。Jevは確率分布から機械的に算出した confidence(0〜1)を返します。分布が1つに尖っていれば高く、散らばっていれば低い。これを使うと、迷ったものだけ人に回すという設計が素直に書けます。
公式が出しているのは3段階の目安です。
| confidence | 扱い |
|---|---|
| 0.9超 | 自動で実行してよい |
| 0.5〜0.9 | 慎重に。ユーザーに確認するか、レビューに回す |
| 0.5未満 | 実行しない。人に回すか、聞き返す |
ポイントは、しきい値を操作の重さに合わせて変えることです。残高表示と送金承認で同じしきい値を使う理由はありません。
if confidence < 0.5:
    route_to_human(user_message)
elif action.choice == "check_balance":
    show_balance(account_id)                 # 軽い操作は確認なしで実行
elif action.choice == "approve_transfer":
    if confidence > 0.9:
        confirm_then_execute(account_id)
    else:
        ask_user_to_confirm(account_id)      # 重い操作は確認を挟む
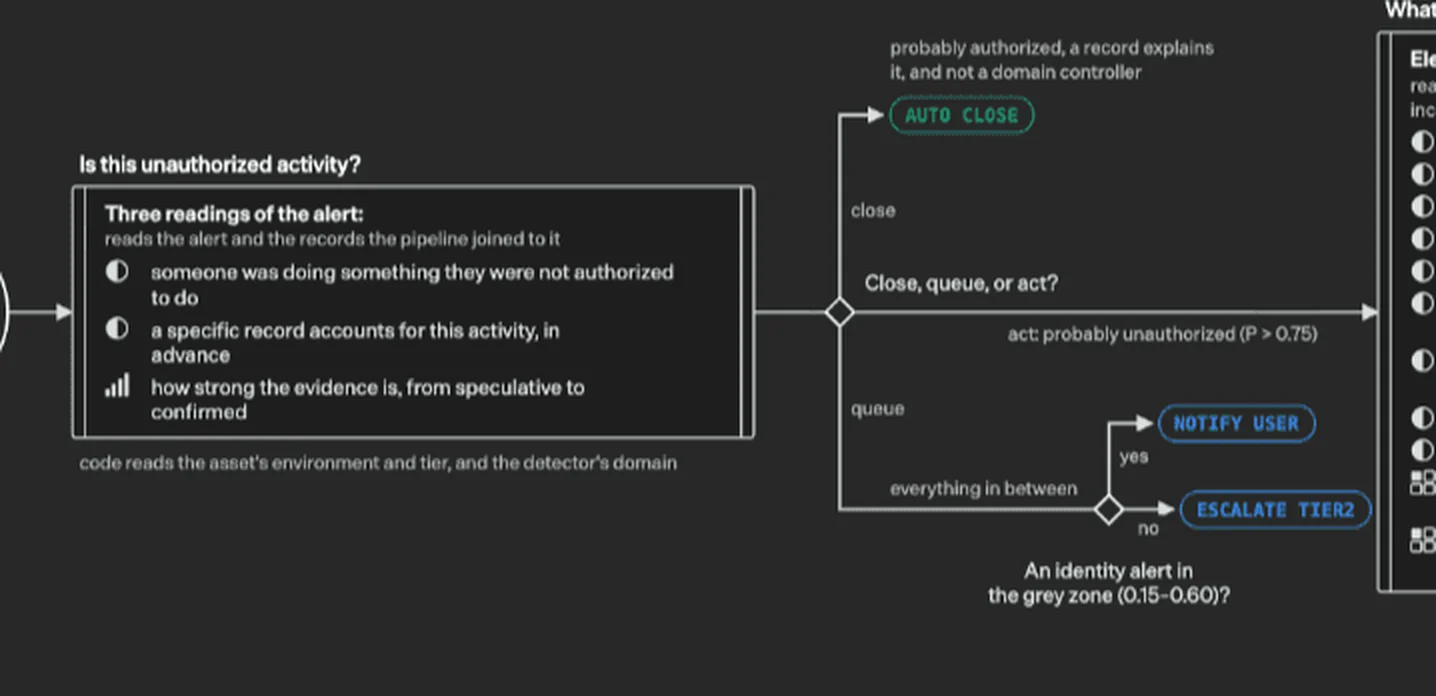
公式が示すインシデント振り分けの一部。確率のしきい値(P > 0.75、0.15〜0.60)がそのまま分岐条件になっている。出典: TypeSafe AI 公式ブログ(図の一部を抜粋)
公式が出しているセキュリティアラートの例が分かりやすい実装です。1本のアラートに対して「許可されていない行為か」をBoolで2問、「証拠の強さ」をScoreで1問投げ、確率が0.75を超えたら対処、0.15を下回ったら自動クローズ、その間(0.15〜0.60)は人に通知するかTier2にエスカレーションと分けています。しきい値がそのまま運用ルールになっている形です。
公式も「この数字はあくまで出発点で、正しいしきい値は領域と自分のデータ次第。保守的に始めて調整すること」と書いています。なお、confidenceの算出式については、公式ドキュメント内の例が互いに食い違っている(最大確率の再スケールとエントロピーの2つが混在している)という指摘がQiitaに出ています。運用上重要なしきい値は、返ってきた probabilities から自分で計算するほうが安全です。
活用事例|どこに効くのか
公式のクックブックと、公開されている導入例から、効きどころを整理します。
01入ってきたものを振り分ける
Jevがいちばん素直にはまる領域です。同じ形式の判断を大量に繰り返す処理。
- 問い合わせの振り分け — 部署の判定、緊急度、解約リスク、顧客が約束した内容の抽出を1回の呼び出しで
- 保険金請求 — 請求内容の分類、複雑さと不正の兆候の判定、処理順の決定
- 採用 — 職務経歴書を要件に照らして採点し、判断がつかないものだけ人に回す
- リード獲得 — 理想顧客像との一致、業種の適合度、購買意欲の検出
02LLMの前後に置いて守る
生成AIアプリの入口と出口に挟む使い方。応答が数百msなので、ユーザーを待たせずに挟めます。
- ガードレール — 入力側で脱獄・プロンプトインジェクション・自傷の兆候を、出力側でポリシー違反や不適切な助言を検出。公式クックブックは「厳格」「寛容」の2つのポリシーで、レビュー0.35/実行0.70〜0.85というしきい値を例示している
- 引用のつき合わせ — LLMが出した主張が、元の文書に本当に書いてあるかを1件ずつ検証
- ツール呼び出しの検査 — エージェントが実行しようとしている操作が、危険かどうかを実行前に判定
03検索とRAGの精度を上げる
埋め込みベクトルの「なんとなく近い」を、明示的な判定に置き換える使い方。
- リランキング — 検索結果の関連度を採点し直す。クロスエンコーダの代わりに使う
- RAGの通過判定 — 取ってきた文章が質問に答えているかを採点し、ノイズを落としてからLLMに渡す
- 行単位の意味検索 — 文書を行ごとに判定して、該当箇所だけ拾う
04コードとワークフローの中に埋める
「LLMに聞くほどではないが、正規表現では書けない」判定を置き換える領域。
- 意味的なLint — チームの命名規約や文章ガイドラインへの適合をCIで検査する
- モデルルーティング — 意図と難易度を判定して、安いモデルで足りるリクエストを振り分ける
- 関数呼び出しの対応づけ — 自然言語を、型の決まった関数に写す
- 日付・数値の抽出と正規化 — 段階を分けた抽出(SDEカスケード)で精度を上げる
リアルタイムの判断|Doomのデモが示したこと
公式のDoomデモは、画像ではなくゲーム状態のテキスト表現をstateとして渡し、毎秒約10回Jevを呼んで行動を決めるものです。コストは1時間あたり約7ドル。ゲームそのものより、「150ms以下でAIの判断を差し込める」という事実の実演として見るべきものです。組み込みUIの分岐や、ゲーム内チャットのモデレーションが同じ枠に入ります。
日本のエンジニアが試していること
Qiitaの公式イベントには、9月時点で14本の記事が投稿されています。内容は大きく3つに分かれます。
- 日本語でまとめて判定させる — 記事の企画案をstateにして、技術的な深さ・実用性・初心者へのわかりやすさなど12項目(Score 8つ+Choice 4つ)を1回で判定させた例。掲載先の判定はQiita 92%/Zenn 8%(confidence 84%)、技術的な深さは1.97/2.00(confidence 96%)。Playgroundの表示は96ms+212msだった
- LLMのif文判定を置き換えられるか — 早期アクセスなしでSDKと公式ドキュメントだけを突き合わせ、confidenceの算出式を逆算した検証。SDK 0.6.0の型検証が、公式のQuick Startの例を弾くという不整合も報告されている
- エージェント設計としての比較 — Amazon Bedrock AgentCoreのようにLLMが次の手順を選ぶ構成と、Jevが分類だけ返してプログラムが分岐する構成を並べ、「処理の進め方を決める責任を、プログラムとAIのどちらに持たせるか」の違いとして整理したもの
海外では、Browserbaseがブラウザ操作エージェントの判断に、別の開発者が取引エージェントやメールのトリアージに使っている例が紹介されています。いずれも数値は公開されていません。
日本語で使うときの注意|公式が「CJKは精度が落ちる」と書いている
ここは日本で使う人にとって一番重要な部分です。公式ドキュメントのstateの説明に、次の趣旨の記載があります。
「CJK(中国語・日本語・韓国語)を含む他言語も受け付けるが、現時点では精度が英語より低い」。Jevの第一言語は英語であり、最良の性能が出るのは英語入力です。
実際に日本語で試した報告では、緊急度の判定で0.97〜0.98が返るなど体感では問題なく動いています。ただし「動いた」と「業務で使える精度が出ている」は別です。現実的な進め方は次の3つです。
- 質問文(instructions・criteria)は英語で書く — stateは日本語のまま渡し、判定の指示だけ英語にする。モデルの得意な言語で指示を与える形になります
- 正解つきのデータで一度測る — 過去の問い合わせを100〜300件、人が付けたラベルつきで用意し、Jevの判定と突き合わせる。ここで初めてしきい値が決まります
- 最初はしきい値を高くして、人を残す — confidence 0.9以上だけ自動化し、残りは人に回す。自動化率は運用しながら上げていきます
苦手なこと|公式が「jaggedness」として公開している弱点
TypeSafe AIは、Jev 1.13の不得意領域を model-jaggedness というページで自ら公開しています。ここを読まずに投入すると事故ります。要点は6つです。
| 弱点 | 具体的に何が起きるか |
|---|---|
| 書いた通りにしか読まない | 限定表現・否定・暗黙の条件を額面通りに解釈する。「意図した質問」ではなく「書いた質問」に答える |
| 数を数えられない | 文字数・出現回数・リストの件数が信頼できない。対象が大きくなるほど誤差が増える |
| 数値の精度が出ない | 16進値やRGB値の扱いが弱く、2つの値が近いかどうかを確実には判定できない |
| 日付・時刻の比較が弱い | 日付を順序のある量ではなくテキストとして読む。前後関係や期間の計算は不得意 |
| 二重否定・複雑な間接表現に弱い | 指示とcriteriaが矛盾していると混乱する |
| 無関係な情報が多いと落ちる | stateに判断と関係ない内容が増えるほど精度が下がる(コンテキストの劣化) |
加えて、関連する質問どうしの数学的な整合は保証されません。「Aである」の確率と「Aでない」の確率を別々のNoulで聞いても、足して1になるとは限りません。整合が必要なら、1つのChoiceにまとめる設計にします。
そしてもう1つ。stateの中に混ざった敵対的な指示に対して脆弱とも明記されています。ユーザー入力をそのままstateに入れる構成では、プロンプトインジェクションの対策が別途必要です。
どこをJevに置き換えるか|LLM・ワークフローとの分担
Jevは汎用LLMの代替ではありません。「LLMにやらせていた仕事の一部を外に出す」ためのものです。実際の構成では次のように分担します。
 Jev | 型の決まった判断だけを、70〜500msで返す
分類・採点・真偽判定に絞ったモデルです。文章は一切書きません。選択肢を事前に列挙できる判断で、同じ形式のものを大量に繰り返す処理に入れます。判断の結果(値と確率)を返すところまでが仕事で、その値をどう扱うかはアプリケーションのコードが決めます。
 Claude | 文章を書く・長い推論をする側は引き続きLLM
要約・下書き・コード生成・複数手順の推論はClaudeの領域です。Jevはそのガードレールや、出力の検証(引用が本当に元文書にあるか)を担当します。両者は競合せず、LLMの前後に薄く挟まる形になります。
 ChatGPT | 分類だけなら小さいモデルという選択肢もある
分類・抽出だけが目的なら、ChatGPTのAPIにも安価なモデル(GPT-5.6 Lunaは入力$0.20/100万トークン)があります。Jevとの差は約5倍の単価差と、出力トークンの有無、パースの要否です。すでにOpenAIで組んでいるなら、まず既存の安価モデルで足りるかを確かめてから比較するのが順序です。
 Dify | ワークフローの分岐条件を、LLMからJevへ移す
Difyのようなワークフローツールでは、条件分岐の判定にLLMノードを置くことがよくあります。この部分は「選択肢が事前に決まっている判断」そのものなので、Jevに置き換えると1ステップあたりの待ち時間が秒からミリ秒になります。フロー全体のレイテンシに効きます。
 Claude Code | 既存コードの判定箇所を探して置き換える
公式スキルを入れたClaude Codeは、リポジトリの中から「壊れやすいパース処理」「正規表現で無理に書かれた判定」を見つけて、Jevの呼び出しに書き換える作業に使えます。質問とconfidenceのしきい値は1つのファイルにまとめておくと、後からレビューしやすくなります。
よくある質問
QJevは無料で使えますか
モデル自体は従量課金ですが、コンソールの請求画面には月5ドル分の無料利用枠があると報告されています(2026年9月時点)。入力100万トークンで$0.042なので、この枠だけでも相当な回数を試せます。利用にはウェイトリストからの案内が必要です。
Q日本語は使えますか
使えますが、公式が「CJKは受け付けるものの、現時点では精度が英語より低い」と明記しています。日本語のstateを渡すこと自体は問題なく、緊急度判定などは実用的な値を返しています。本番投入の前に、自社の正解つきデータで精度としきい値を確認してください。
Q文章の生成や要約はできますか
できません。公式が「テキスト生成の訓練を受けていない」と明記しており、無理に連鎖させて生成させても質が低く、遅いと書かれています。生成はLLMの仕事です。
Q画像やPDFは渡せますか
渡せません。stateはテキストのみで、文字列・JSONオブジェクト・文字列の配列の3形式です。画像・音声・動画は非対応なので、OCRや文字起こしを通してからテキストとして渡すことになります。
Q「200倍速い・400倍安い」は本当ですか
すべてTypeSafe AI自身の測定です。独自に作った「ワークフローevals」という評価枠組みによるもので、使ったワークフローの中身は公開されておらず、第三者検証もまだ出ていません。桁が違うのは確かですが、自分の処理での倍率は自分で測るのが前提です。
まとめ
Jevが持ち込んだのは、新しい性能ではなく新しい分業です。これまでLLMに一括で預けていた仕事のうち、「選択肢が事前に決まっている判断」だけを切り出し、桁違いに速く安い専用モデルに渡す。残りの生成と推論はLLMが持つ。
まず試すなら、いま本番でLLMに投げている処理のうち、戻り値をJSONでパースしている箇所を1つ選んでください。そこがJevの守備範囲です。Playgroundで同じ入力を10件流し、判定が一致するかを見るだけで、置き換えられるかどうかはすぐ分かります。
本番に入れる前に決めることは2つ。confidenceのしきい値(操作の重さごとに変える)と、しきい値を下回ったものを誰が見るか。この2つが決まっていれば、判断が外れたときに事故になりません。
本記事の情報は2026年9月19日時点で、TypeSafe AIの公式サイト・公式ドキュメント・公式ブログに公開されている内容と、公開されている検証記事にもとづきます。早期アクセス中の製品であり、仕様・料金・レート制限は変更される可能性があります。最新の情報は公式サイトをご確認ください。
この記事で紹介したAIツール

関連記事
Claude Fable 5・GPT-5.5・Gemini 3.1 Proはどれを選ぶべき?性能・料金・使い分けを徹底比較【2026年7月版】
2026年前半に出揃った三強の最新フラッグシップモデル、Claude Fable 5・GPT-5.5・Gemini 3.1 Proを徹底比較。ベンチマーク性能、API料金、コンテキストウィンドウ、マルチモーダル対応、ChatGPT Plus/Claude Pro/Google AI Proなど消費者向けプランでの使い方まで、公式データを中心に用途別のおすすめを解説します。
GPT-6 Astraとは【2026年9月最新】ChatGPTのどのプランで使えるか・API料金・GPT-5.6との使い分け
2026年9月3日(米国時間)にOpenAIが発表したGPT-6 Astraは、「PCでできることは、すべて代行できる」と打ち出した通り、コンピュータ操作と複数手順の長い作業に振ったフラッグシップです。OSWorld 2.0で72.6%、1タスクの所要時間はGPT-5.6 Solの約75分から約40分へ47%短縮。この記事では、何が変わったのかをベンチマークで確かめたうえで、ChatGPTのプラン別にどこで使えるか——Pro(¥16,800/¥30,000)・Business・EnterpriseはChatの「GPT-6 Pro」、Plus(¥3,000)はChatGPT WorkとCodex経由、無料・Goは対象外——と、週50通・週200通といった上限、APIの単価(入力$10/出力$50でSolの2.5倍)とSol・Terra・Lunaとの使い分け、確認質問が増える・スキルファイルに敏感になるといった乗り換え時の挙動の変化を、OpenAIの公式発表・ヘルプセンター・モデルページにもとづいて整理します。
Cloudflare OSとは|オープンソースのAIエージェント・ワークスペースを徹底解説【仕組み・Gatekeeper・自社ホスト・料金】
Cloudflareが2026年8月5日にオープンソース公開したAIエージェント・ワークスペース「Cloudflare OS」を解説。ゼロ権限から始まるGatekeeperセキュリティ、AI Gatewayによるモデル選択とコスト管理、Gadget(小さな自作アプリ)、自社のCloudflareアカウントへのデプロイ手順、料金までを公式ブログとGitHubの記載にもとづいてまとめました。
Sakana AI Fuguの使い方|APIキー発行からClaude Code連携まで。料金・無料枠・性能も解説
Sakana AIのマルチエージェント基盤Fuguを解説。console.sakana.aiでのAPIキー発行、OpenAI互換APIの呼び出し方、CodexやClaude Codeと連携する手順を具体的に紹介。Fugu/Fugu Ultra/Fugu Cyberの使い分け、料金と無料枠の有無、ベンチマーク性能までまとめました。
Claude Fable 5とは|Anthropic最新フロンティアモデルの性能・料金・使い方を徹底解説
Anthropicが2026年6月に公開した最新モデルClaude Fable 5を解説。コーディング・知識労働・科学分野でのベンチマーク性能、Mythos 5との違い、API料金、使い方までを公式データとともに紹介します。
【2026年版】開発者の業務を革新するAIツール20選|コーディング支援・コードレビュー自動化・ノーコードWebサイト開発構築、ワークフロー自動化まで網羅
2026年最新の開発者向けAIツールを厳選紹介。コーディング支援、コードレビュー自動化、ノーコード開発、ワークフロー自動化など、業務効率化を実現する18のツールを解説。