Jev 是什么【2026年10月最新】不生成文本的 AI 的用法・价格|与 Microsoft-Decision-1 的区别
2026 年 10 月 9 日,Microsoft 发布了与 Jev 同价(每百万输入 token 0.042 美元、输出免费)、提问类型也相同的判断专用模型「Microsoft-Decision-1」。本文先梳理 TypeSafe AI 于 9 月 15 日发布的 Jev 是什么——不生成文本、以概率形式返回 Choice(分类)・Score(评分)・Noul(0〜1 真值)的「System One 模型」的原理,堆再多问题响应时间也几乎不变的投机式 fan-out,从候补名单到 Python SDK・HTTP API・Claude Code skill 的用法,用 confidence 把拿不准的交给人的设计,以及应用案例——再比较它与 Microsoft-Decision-1 的区别(提供途径・上下文长度・提供状态・日语支持)、该选哪个、在日本能否使用,以及 Jev 在 10 月的最新状况(A 轮融资・速率限制・OpenRouter 上架)。同时也覆盖官方明确的「CJK 准确率低于英语」以及官方公开的弱点。
2026 年 10 月 13 日更新:2026 年 10 月 9 日(美国时间),Microsoft 发布了与 Jev 同价(每百万输入 token 0.042 美元、输出免费)的判断专用模型「Microsoft-Decision-1」,提问类型也与 Jev 相同,都是 Choice・Score・Noul 三种。两者的区别、该选哪个、在日本能否使用,汇总在「2026 年 10 月续报」一节;Jev 的提供状态和速率限制也已按最新官方信息更新。
2026年9月15日,潜行两年的创业公司TypeSafe AI带着4,000万美元融资正式亮相,并以早期访问的形式发布了首个模型Jev。次日 The Register 以「为机器而非人类准备的模型」进行报道,消息在 X 与 Bluesky 上扩散,日本的技术社区 Qiita 与 Zenn 上也出现了大量实测文章——Qiita 甚至从9月16日到10月2日举办了官方活动「你试过了吗?和判断专用 AI『Jev』一起玩!」。
引爆讨论的并不是跑分,而是它定位的直观:一个不生成文本的 AI。Jev 不聊天。它不会用文章回答提示词,而是从你事先定义好的选项中挑出一个,并附上概率返回。拿到手的是 "technical"、1.6、0.92 这类可以直接塞进 if 的值。
本文基于 TypeSafe AI 的官方文档与官方博客,以及已公开的实测报告,梳理 Jev 实际返回什么、Choice / Score / Noul 三种提问类型如何选用、价格与速度、从加入候补名单到发出第一个请求的完整流程,以及用非英语输入时需要注意的地方。
先看结论
Jev 属于「System One 模型」这一新的模型类别,它不写文本。传入一个 state(文本或 JSON)和一组类型固定的问题,它会返回 Choice(分类)、Score(评分)、Noul(0〜1 的真值),每一项都带概率。因为不生成字符串,所以既没有需要解析的对象,也没有需要校验丢弃的坏输出。
又快又便宜:端到端 70〜500 毫秒,输入每百万 token 0.042 美元,输出 token 免费。问题是并行评估的,所以一次调用里堆十个问题,响应时间几乎不变。这正是它与 LLM 在设计上的分水岭。
但官方文档明确写着:包括中文、日文、韩文在内的 CJK 文字可以接受,但目前准确率低于英语。这个模型的第一语言是英语。要在非英语输入上投产,就必须先用自己的标注数据测一遍,再决定置信度阈值。
2026 年 10 月 9 日,Microsoft 发布了价格相同、提问类型也相同的「Microsoft-Decision-1」。区别在于提供方式:Jev 为早期访问(候补名单制),上下文 64,000 token;Decision-1 只要有 Azure 订阅即可立即在 Microsoft Foundry 部署(预览),上下文 32,768 token。希望把合同和认证统一到 Azure,可考虑 Decision-1;需要长输入或官方 SDK・智能体 skill,可考虑 Jev。
2026 年 10 月续报:Microsoft 发布同价的「Microsoft-Decision-1」
2026 年 10 月 9 日(美国时间),Microsoft 发布了判断专用模型 Microsoft-Decision-1(Microsoft 的发布文章)。它不生成文本,而是为每个固定的候选答案返回概率,与 Jev 属于同一类模型。价格也与 Jev 相同:每百万输入 token 0.042 美元,输出免费。
 Microsoft-Decision-1 | 与 Jev 同价、同提问类型,可通过 Azure 使用的判断模型
- 基础 — 由 Microsoft 对阿里巴巴的 Qwen3.5-9B(Qwen 系列的小型模型)进行后训练。发布文章称今后计划改以 Microsoft AI(MAI)和 OpenAI 的模型为基础重建
- 提问类型 —
noul(为真的概率)・choice(从候选中选一个)・score(有序等级上的值)三种。类型名称以及传入state和questions的请求形式都与 Jev 几乎相同,Microsoft 的文档自己也写着「类似 System One API 的请求形式」 - 提供方式 — Microsoft Foundry(模型目录中标注为预览)和 OpenRouter(提供方为 Azure)
- 上下文与输入 — 32,768 token。仅限文本(字符串或 JSON),不支持图像、音频、视频
- Microsoft 内部的用法 — Xbox Research 用它处理 1 万多条开放式反馈,Copilot 团队用它衡量聊天和智能体回复的质量,Microsoft Discovery 用它在智能体评估实验结果后判断如何重新规划
Microsoft 称,在未用于训练的 36 个基准(约 15 万道题)上比较,它取得了最高准确率,响应时间中位数约为 GPT-6 Sol 的 1/35。比较对象据称包括判断模型公开排行榜 JevBench 上的顶级模型,发布文章在公开后更新,注明「增加了 Jev 在准确率和校准方面的基准」。以上均为 Microsoft 自己的测量,目前尚无第三方验证。
Jev 与 Microsoft-Decision-1 的区别
| 对比项 | Jev | Microsoft-Decision-1 |
|---|---|---|
| 提供方 | TypeSafe AI(美国初创公司) | Microsoft |
| 发布 | 2026 年 9 月 15 日 | 2026 年 10 月 9 日 |
| 输入价格(每百万 token) | 0.042 美元 | 0.042 美元 |
| 输出价格 | 免费 | 免费 |
| 提问类型 | Choice・Score・Noul | choice・score・noul |
| confidence | Choice・Score 附带专用值 | 文档未说明(根据各候选项的概率判断) |
| 上下文长度 | 64,000 token(state 与最长问题合计 32,000 以内) | 32,768 token |
| 输入 | 仅文本 | 仅文本 |
| 提供途径 | TypeSafe AI 的 API、OpenRouter | Microsoft Foundry、OpenRouter |
| 提供状态 | 早期访问(候补名单制) | 预览(Foundry 模型目录的标注) |
| 开始使用需要 | 候补名单的邀请 | 已登记付款方式的 Azure 订阅 |
| 面向开发者的工具 | 官方 Python・JavaScript/TypeScript SDK、智能体 skill、cookbook | HTTP API(Entra ID 或 API 密钥认证)、通过 Azure CLI 部署 |
| 日语 | 可接受,但官方明确「准确率低于英语」 | 无按语言的说明(只写了评估包含多语言任务) |
| 公开的弱点 | 专门页面列出 6 项(数不清数量、日期比较弱等) | 对措辞和候选项顺序敏感、不返回理由、不应作为涉及个人的重大判断的唯一依据 |
价格均为不含税标价。通过 Azure 结算的金额取决于合同币种和税务处理。
在日本能用吗
- Microsoft-Decision-1 — 只要有 Azure 订阅,就能从 Microsoft Foundry 的模型目录部署。部署类型有两种:推理可能在任意 Azure 区域处理的
GlobalStandard,以及部分区域可选、在数据区域内处理的DataZoneStandard。截至 2026 年 10 月 13 日,官方区域列表中尚未显示日本区域(日本东部・日本西部)是否可用。如果数据必须在日本境内处理,请在部署前于 Foundry 界面确认可选区域 - Jev — 没有限制在日本使用的说明,也有日本工程师报告已进入控制台试用。但它处于早期访问阶段,需要等待候补名单的邀请
- 日语准确率 — 两者都没有公布日语准确率的数字。Jev 明确写着「CJK 准确率低于英语」,Decision-1 没有按语言的说明。无论选哪个,都要先用自己的日语数据测量
该选哪个
- 希望把合同・结算・认证统一到 Azure(用 Entra ID 管理、在数据区域内处理)→ Microsoft-Decision-1
- 希望一次性判断长输入(单次请求 64,000 token,用投机式 fan-out 堆大量问题)→ Jev
- 希望直接用官方 SDK・智能体 skill・实现示例快速搭建 → Jev
- 拿不定主意 → 两者的请求形式几乎相同,把同样的 state 和问题发给两者,用自己的标注数据比较准确率和响应时间最可靠
此外,OpenAI 也于 2026 年 10 月 6 日以公开测试版发布了同类的「Decisions API」(OpenAI 文档)。模型仅有 gpt-6-luna,每百万输入 token 0.10 美元、输出免费,并支持图像输入。短短一个月,判断专用模型已经成为有三家厂商的领域。
Jev 在 10 月的动态
- 完成 8.7 亿美元 A 轮融资 — 由 Andreessen Horowitz 领投,Sequoia Capital 和 DCVC 参投,估值 75 亿美元(官方博客;据报道于 10 月 9 日宣布)。距 9 月 4,000 万美元的种子轮不到一个月
- 公开首个客户案例 — 招聘匹配平台 Jack & Jill 把 Gemini 3.1 Flash Lite 换成 Jev 后,每 1,000 名候选人的成本从 0.755 美元降到 0.092 美元(降低 88%),筛选耗时中位数从 20.3 秒缩短到 10.3 秒(官方博客)
- 仍为早期访问 — 官网的说明仍是「early access」。速率限制改为每秒 100,000 token/每秒 80 次请求(9 月本文首次发布时为每秒 250,000 token/每分钟 1,200 次请求)
- 已在 OpenRouter 上架 — Jev 1.13 自 9 月 17 日起在 OpenRouter 上架(价格相同)。9 月 26 日,按请求选择 LLM 与推理强度的「Jev Router」也已上架
为什么现在突然火了
一周之内叠加了三件事。
结束潜行,同日发布
- TypeSafe AI 宣布 4,000 万美元融资(DCVC 领投)
- Forbes 报道估值接近 2 亿美元
- Jev 开放早期访问
玩 Doom 的演示扩散
- The Register 报道
- 每秒约 10 次调用操控 Doom 机器人
- 成本约每小时 7 美元
进入开发者社区
- Qiita 官方活动(至 10 月 2 日)
- Zenn 上的实测记录与解析文章
- 「不生成文本的 AI」成为传播点
关于 Doom 演示:负责的工程师自己也承认「不用 AI 的 Doom 机器人玩得更好」。那是速度与成本的实演,不是性能主张。
值得注意的是,讨论的重心不是「取代 LLM」,而是「把原本丢给 LLM 的判断挪出去」。分类、定优先级、护栏判定——这些活儿以前只能无奈地交给 GPT 或 Claude,要求它返回 JSON,再在 JSON 坏掉时重试。Jev 只负责这一段。
官方公布值
输出 token 免费
state 上限 32k
DCVC 领投・2026年9月
什么是 System One 模型
TypeSafe AI 把 Jev 定位为System One 模型这一新模型类别的首款产品。名字来自丹尼尔・卡尼曼的《思考,快与慢》。
- 系统 1 — 快速、自动、直觉式。看脸识情绪,听语气知道对方生气了
- 系统 2 — 缓慢、有意识、按步骤。多位数乘法,方案权衡
当下的 LLM,包括思维链在内,都是朝系统 2 造的。但实际业务系统需要的判断,绝大多数是系统 1 的活:「这张工单归哪个部门」「这句话是否紧急」。此前每次都得搬出系统 2 那台机器。
模型名Jev取自经济学家威廉・斯坦利・杰文斯。他因「杰文斯悖论」——效率提升反而会让总需求增加——而闻名,寓意是:一旦判断足够便宜、足够快,判断的次数就会爆炸式增长。
和让 LLM 分类有什么不同
用 LLM 做分类
- 返回的是字符串,即使 JSON 模式也要校验
- 可能自创你没定义过的标签
- 没有概率,看不出它在犹豫
- 顺序采样,几秒到几十秒
- 问题越多,越慢越贵
用 Jev 做判断
- 返回的是类型固定的值,无需解析
- 答案不会跑出你定义的集合
- 必定附带概率分布与 confidence
- 并行评估,70〜500 毫秒
- 问题变多,响应时间几乎不变
把官方的对比换成数字如下。LLM 一侧是各家常见的区间。
| 维度 | 通用 LLM | Jev |
|---|---|---|
| 输出形态 | 文章(字符串) | 类型固定的值+概率 |
| 解析・校验 | JSON 模式下仍需要 | 不需要 |
| 采样方式 | 顺序 | 并行 |
| 响应时间 | 3〜329 秒 | 70〜500 毫秒 |
| 输入单价(每百万) | $0.20〜$10 | $0.042 |
| 输出单价 | 约为输入的 5 倍 | 免费 |
| 擅长 | 生成、长推理、对话 | 分类、评分、真假判定 |
请注意「零幻觉」这句话的含义。官方说的是类型不会坏:没定义过的标签不会出现,数值一定落在你设定的范围内。但它并没有说判断本身是对的。正如一篇实测文章所指出的:「类型被遵守了,并不排除模型误解输入含义的可能」。输出格式的保证和正确率是两回事。
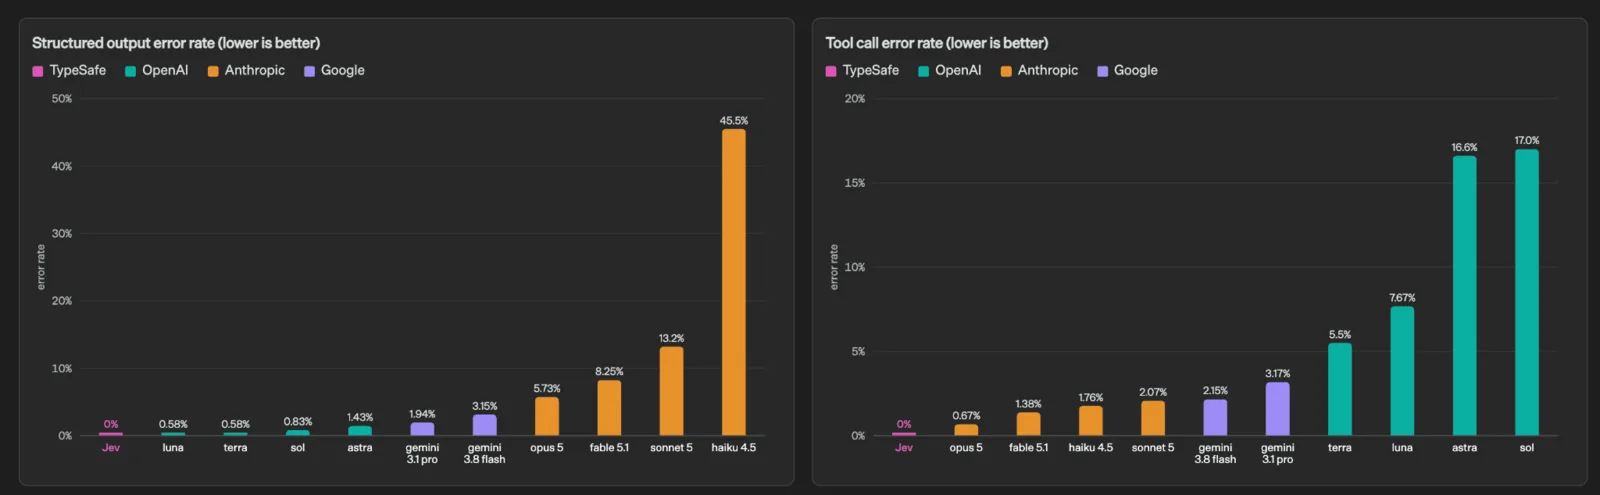
类型出错比例的对比(左为结构化输出,右为工具调用,均为越低越好)。出处:TypeSafe AI 官方博客
官方公开的就是这两张图。结构化输出错误率:Jev 为 0%,GPT-5.6 Luna 为 0.58%,Claude Haiku 4.5 为 45.5%。工具调用错误率:Jev 为 0%,Claude Opus 5 为 0.67%,GPT-5.6 Sol 为 17.0%。这里量的是「有没有按指定类型返回」,而不是判断对不对。即使用了 JSON 模式也甩不掉重试逻辑,原因就写在这组数字里。
返回什么:只有 Choice、Score、Noul
能向 Jev 提的问题只有三种。这个约束本身,就是类型不会坏的原因。
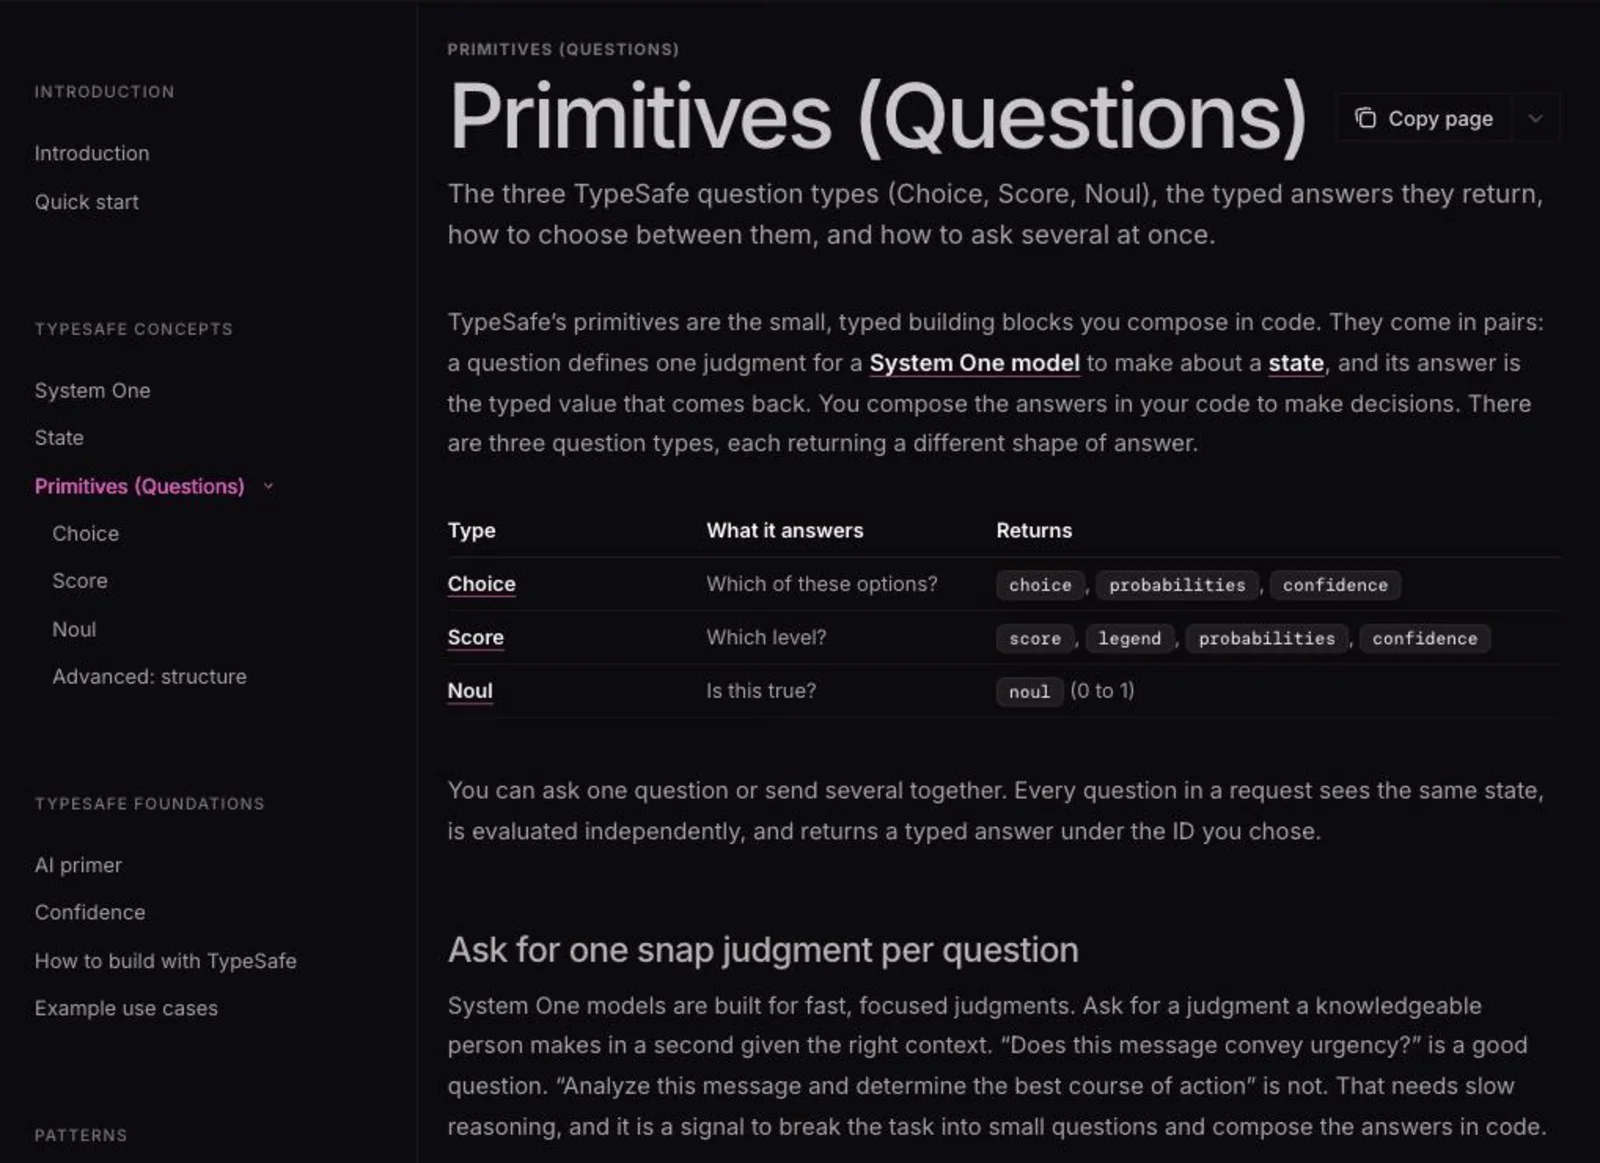
官方文档的 Primitives 页面,左侧导航依次是 Choice、Score、Noul 以及 Confidence、Patterns。出处:TypeSafe AI 官方文档
Choice|从固定选项中选一个
无顺序的分类。工单分流、文档类别、语种判定等。
Choice(
    instructions="Which team should handle this",
    criteria={
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions",
    },
)
返回 choice(选中的键)、probabilities(全部选项的概率分布)、confidence(分布有多集中)。官方建议:如果输入有可能落在列表之外,就加上 other 或「以上都不是」。
Score|在有序的等级上评分
等级本身有含义的量表:缺陷严重度、客户不满程度、熟练度。
Score(
    instructions="How frustrated the customer appears",
    criteria=[
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language",
    ],
)
score 会取等级之间的值,比如 1.6,因此「介于 1 和 2 之间」可以直接表达。同时返回 legend(等级对照表)、probabilities、confidence。
Noul|「这句话为真的概率是多少」
Jev 独有的类型。问的是是非题,但返回的不是 true / false,而是0〜1 的概率。
Noul(
    instructions="The message conveys urgency or time-sensitivity",
)
接近 1 是强烈的「是」,接近 0 是强烈的「否」,0.5 附近表示判断不了。Noul 没有单独的 confidence 字段——概率本身就代表确信度。
官方特别提醒不要混淆 Score 和 Noul。想表达「熟练度中等」时不要用 Noul 返回 0.5,那意思是「无法判断是或否」,不是「处于中间」。
问题堆多少个,都不会更慢
Jev 设计里最见效的就是这点。一次请求里的问题全部并行评估,官方文档写明「增加问题通常完全不会增加响应时间」。
由此产生了投机式 fan-out 的写法:连只在某个分支才用得上的问题,也一起发出去。
response = client.system_one(
    state=ticket,
    questions={
        "category": Choice(...),        # 总是要用
        "bug_severity": Score(...),     # 只有是缺陷时才用
        "has_repro": Noul(...),         # 只有是缺陷时才用
        "refund_requested": Noul(...),  # 只有是账单问题时才用
        "frustration": Score(...),      # 总是要用
    },
)
如果这张工单其实是功能需求,bug_severity 的结果扔掉就行。换成 LLM,就得「先分类,再看结果追问一次」,多一个来回。
价格与速度:输出免费的定价设计
截至 2026 年 10 月,公开的模型仍只有 Jev 1.13 一个系列。
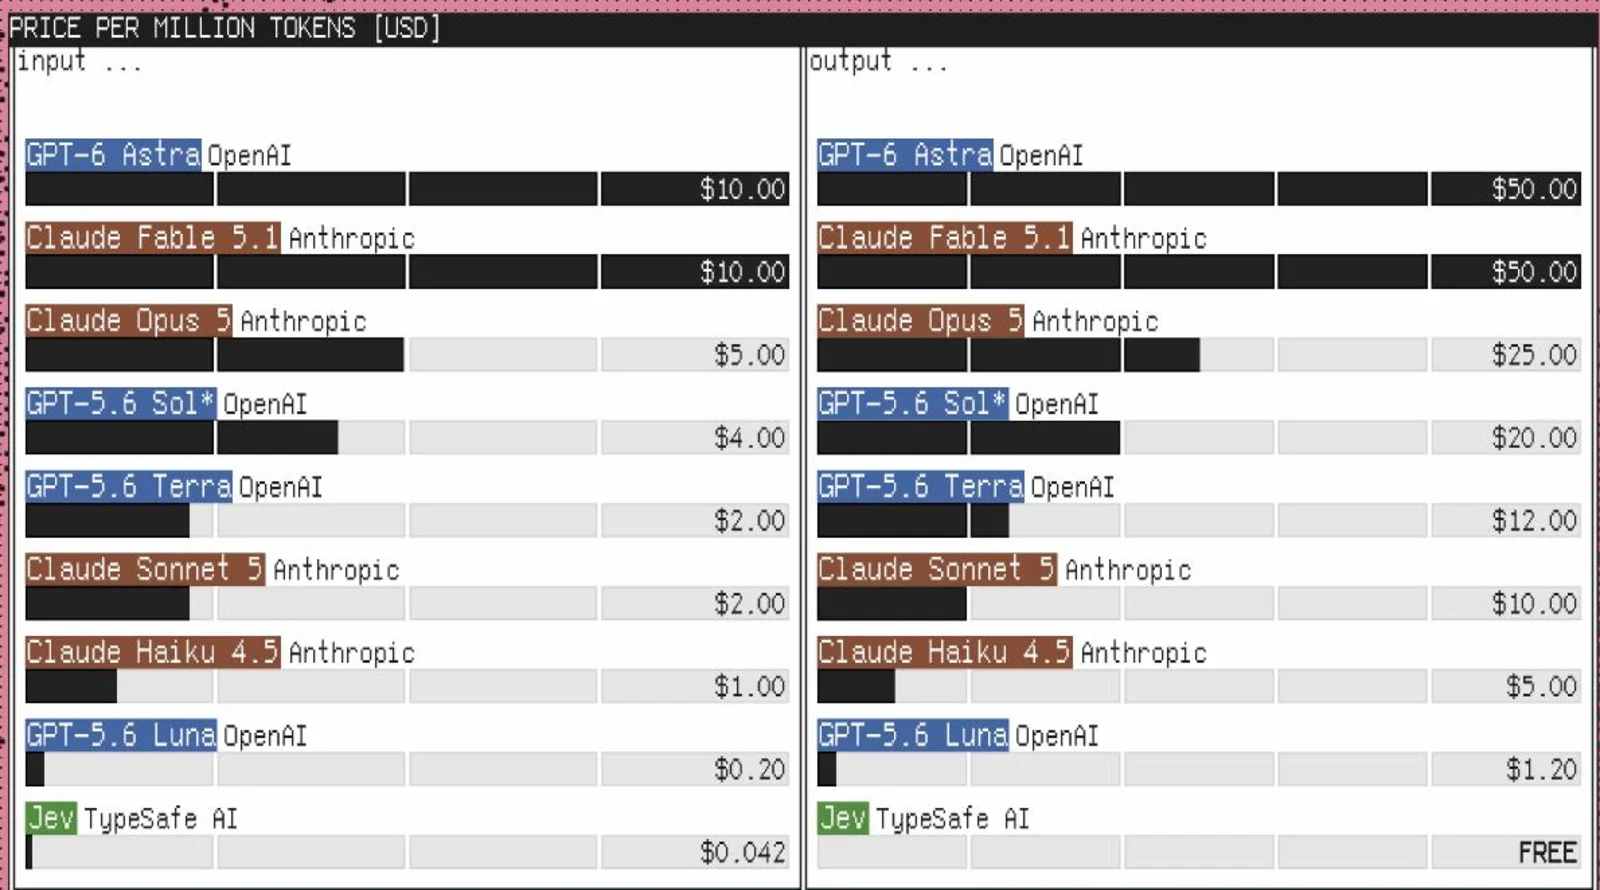
官网主打的价格对比。右侧输出单价一栏,只有 Jev 写着 FREE。出处:TypeSafe AI 官网
官网打出的口号是「输入单价比 Claude Fable 5.1 低 238 倍」「在 System One 工作流上快 193.6 倍、便宜 444.6 倍」。
这些数字全部是 TypeSafe AI 自测的。他们没有用带标准答案的既有基准,而是自建了一套叫「workflow evals」的评测框架,以 GPT-6 Astra 与 Fable 5.1 的预测作为参考概率来比较。基准名称和四个工作流的内容都没有公开,也还没有第三方验证。决定采用之前,请用自己的数据测。
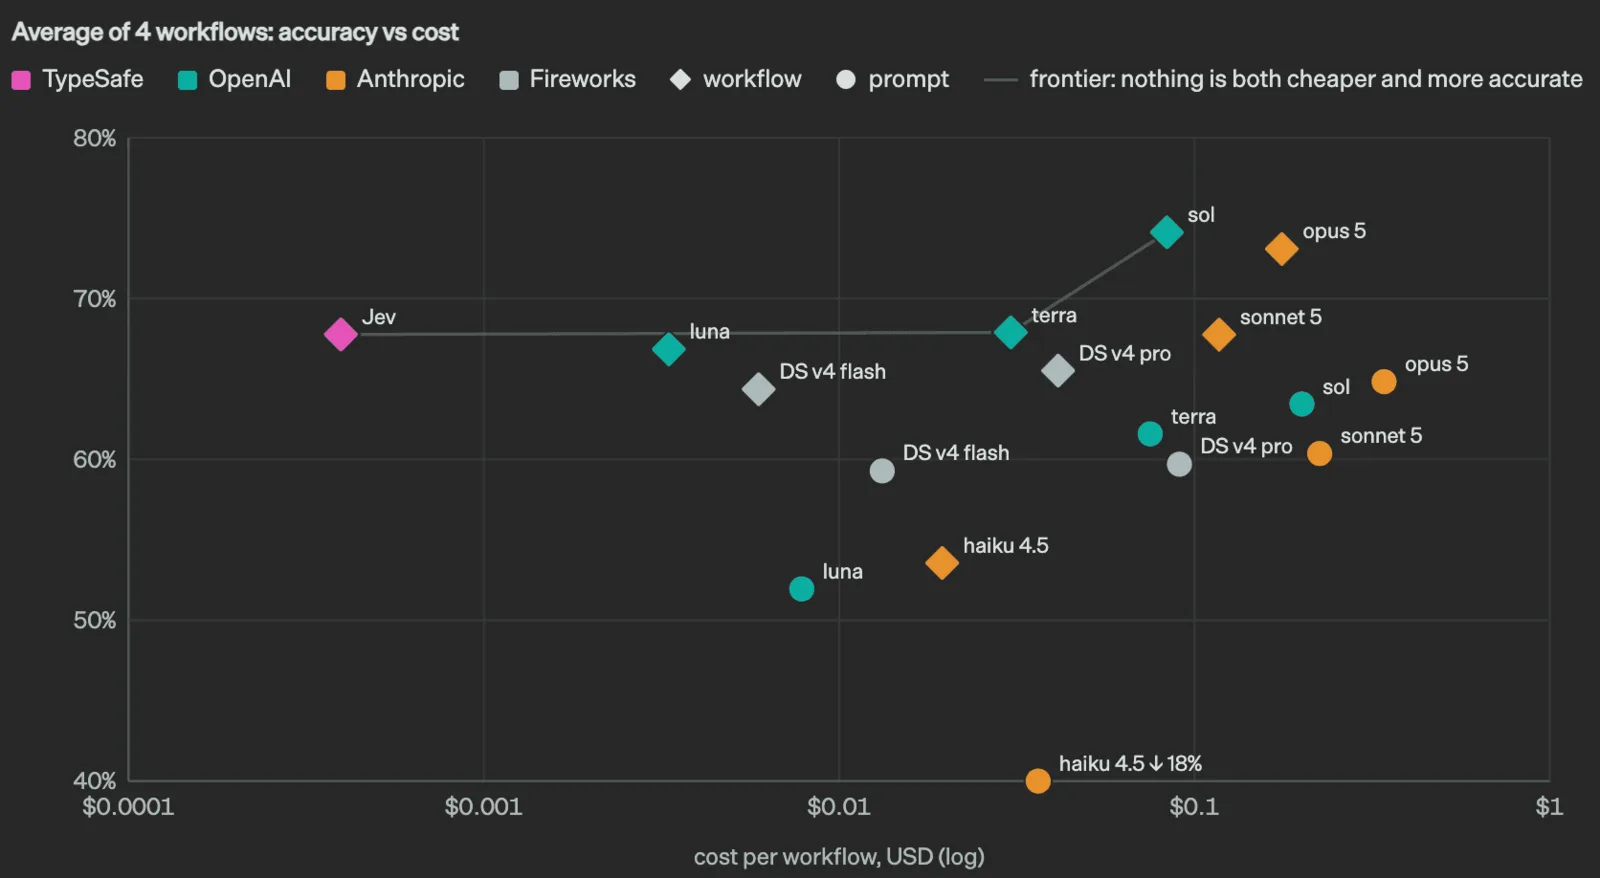
精度与成本的关系,横轴是每个工作流的费用(对数刻度)。出处:TypeSafe AI 官方博客
这张图比任何倍率都更准确地说明了 Jev 的位置。Jev 并不是精度最高的模型。四个工作流的平均精度约为 68%,比 GPT-5.6 Sol 的约 74% 低了 6 个百分点。Jev 所处的位置是「用低两个数量级的成本,做到差不多的精度」:Luna 约 $0.003 做到约 67%,Terra 约 $0.04 做到约 68%,而 Jev 用约 $0.0004 做到约 68%。
所以判断的分水岭不是「Jev 聪不聪明」,而是这个处理值不值得为 6 个百分点的精度买单。如果设计上已经把拿不准的交给人(用 confidence 分流),便宜就更划算;如果漏掉一条的代价很高,留在 Sol 上更稳妥。
即便如此,差两个数量级的价格仍然无法忽视。假设每天分类 10 万条工单,每条 400 token,输入就是每天 4,000 万 token:Jev 是每天 1.68 美元,输出免费。同样的活交给输入 2.00 美元/输出 12.00 美元的模型,即使每条只输出 50 token,一天也要 140 美元上下。
用法:从注册到第一个请求
-
加入早期访问候补名单
在 typesafe.ai 上登记。截至 2026 年 10 月,官网的说明仍是早期访问。9 月时点官方称「正在尽快按顺序从候补名单中邀请」,已有开发者报告注册后不久就收到了邀请邮件。
-
生成 API 密钥
在 console.typesafe.ai 建号并生成密钥。密钥只在生成时显示一次,请当场保存。环境变量名是
TYPESAFE_API_KEY。 -
先在 Playground 里试手感
控制台的 Playground 左侧写 state(纯文本),右侧写 questions(JSON),并会显示实测延迟。装 SDK 之前先在这里把问题的措辞磨好,是更快的路径。
-
用 Python SDK 调用
pip install typesafe-sdkfrom typesafe_sdk import Choice, Noul, Score, TypeSafeClient client = TypeSafeClient() ticket = "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP." response = client.system_one( state=ticket, questions={ "department": Choice( instructions="Which team should handle this", criteria={ "billing": "Payment or subscription issues", "technical": "Bugs or integration problems", "sales": "Pricing or account questions", }, ), "frustration": Score( instructions="How frustrated the customer appears", criteria=[ "Calm, just stating facts", "Frustrated but civil", "Very angry, strong language", ], ), "is_urgent": Noul( instructions="The message conveys urgency or time-sensitivity", ), }, ) print(response.answers["department"].choice) # "billing" print(response.answers["frustration"].score) # 1.035 print(response.answers["is_urgent"].noul) # 0.999JavaScript/TypeScript 则是
npm install @typesafe-ai/sdk(需 Node.js 20 以上)。调用client.systemOne()时,返回值的类型会从问题定义中推导出来。 -
直接调 HTTP API
不用 SDK 时,向
POST https://api.typesafe.ai/v1/systemone发请求,认证用Authorization: Bearer <API_KEY>。{ "state": "Help! My payouts have been failing for 3 days.", "model": "jev-latest", "questions": { "is_urgent": { "type": "noul", "instructions": "Does this convey urgency?" }, "department": { "type": "choice", "instructions": "Which team should handle this?", "criteria": { "billing": "Payments, invoicing, refunds", "technical": "Bugs, outages, integrations", "sales": "Pricing, upgrades, new accounts" } } } }返回如下。
usage里会给出输入与输出的 token 数,但计费只看输入。{ "model": "jev-latest", "answers": { "is_urgent": { "type": "noul", "noul": 0.92 }, "department": { "type": "choice", "choice": "technical", "probabilities": { "billing": 0.08, "technical": 0.85, "sales": 0.07 }, "confidence": 0.82 } }, "usage": { "input_tokens": 312, "output_tokens": 48 } } -
从编码代理里用
官方发布了面向代理的 skill。Claude Code 只要两行:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
其他代理用
npx skills add typesafe-ai/skills --skill typesafe-ai。装上之后代理就掌握了三种提问类型和设计模式,可以在现有代码里找出「脆弱的解析处理」并改写。不过官方自己也写道:「代理不太擅长写问题,请做好一起修改的准备」。问题的设计仍然是人的工作。
confidence:接住「拿不准」,交给人
让 LLM「顺便返回确信度」,得到的只是它自己写的作文。Jev 返回的 confidence(0〜1)是从概率分布机械算出来的:分布集中就高,分散就低。有了它,只把拿不准的交给人这种设计就能自然地写出来。
官方给的是三档参考值。
| confidence | 处理方式 |
|---|---|
| 高于 0.9 | 可以自动执行 |
| 0.5〜0.9 | 谨慎处理:向用户确认,或转人工复核 |
| 低于 0.5 | 不要执行。交给人,或反问澄清 |
关键在于按操作的轻重来调整阈值。查询余额和批准转账没有理由共用同一个阈值。
if confidence < 0.5:
    route_to_human(user_message)
elif action.choice == "check_balance":
    show_balance(account_id)                 # 轻操作:直接执行
elif action.choice == "approve_transfer":
    if confidence > 0.9:
        confirm_then_execute(account_id)
    else:
        ask_user_to_confirm(account_id)      # 重操作:先确认
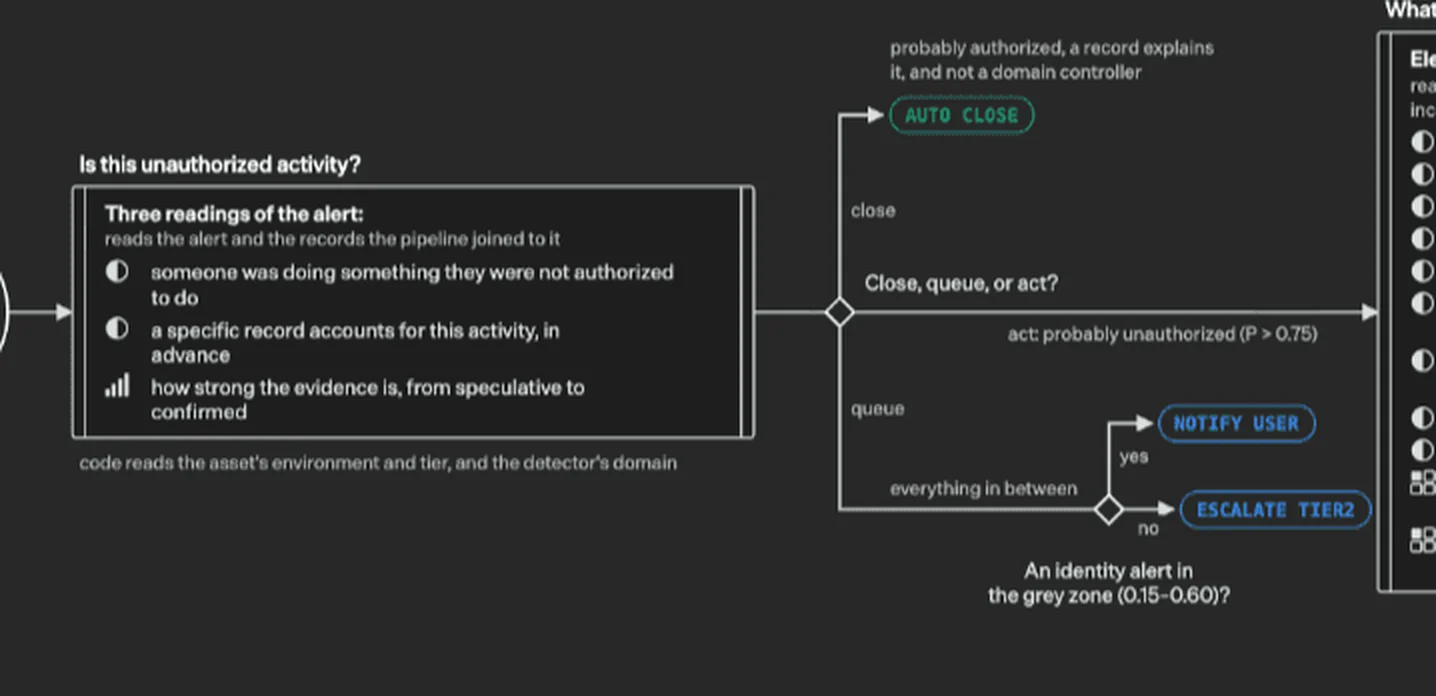
官方给出的事件分流流程的一部分。概率阈值(P > 0.75、0.15〜0.60)本身就是分支条件。出处:TypeSafe AI 官方博客(节选自整张图)
官方给出的安全告警示例是最清楚的一种实现。对一条告警,用 2 个 Bool 问「是否是未授权行为」、用 1 个 Score 问「证据有多强」,然后:概率高于 0.75 就处置,低于 0.15 就自动关闭,介于两者之间(0.15〜0.60)则通知用户或升级到 Tier 2。阈值本身就是运营规则。
官方也写道,这些只是起点,「正确的阈值取决于你的领域和你的数据。先保守,再调整」。另外有实测文章指出,官方文档中示例所隐含的 confidence 计算公式并不一致(有的符合最大概率再缩放,有的符合基于熵的算法)。真正关键的阈值,建议自己从返回的 probabilities 算。
应用案例:用在哪里最划算
结合官方 cookbook 与已公开的使用情况来看。
01给涌进来的东西分流
最自然的适配区:同一种判断,大量重复。
- 工单分流 — 部门归属、紧急度、流失风险、客户承诺了什么,一次调用全拿到
- 保险理赔 — 报案内容分类、复杂度与欺诈迹象判定、处理顺序
- 招聘 — 按要求给简历打分,只把拿不准的交给人
- 线索获取 — 与理想客户画像的匹配度、行业契合度、购买意向
02包在 LLM 的前后当护栏
放在生成式应用的入口和出口。几百毫秒的响应,可以在用户察觉不到的情况下插进去。
- 护栏 — 入口侧检测越狱、提示注入、自伤倾向;出口侧检测违规与不当建议。官方 cookbook 给出「严格」「宽松」两套策略,复核阈值 0.35、执行阈值 0.70〜0.85
- 引用核对 — 验证 LLM 给出的论断在原文档中是否真的存在
- 工具调用检查 — 在执行前判断代理即将进行的操作是否危险
03提升检索与 RAG 的精度
把向量的「大致相近」换成明确的判定。
- 重排序 — 重新给检索结果的相关度打分,替代 cross-encoder
- RAG 段落过滤 — 评估取回的文本是否真的回答了问题,先滤掉噪声再交给 LLM
- 逐行语义检索 — 对文档逐行判定,只捞出命中的部分
04嵌进代码和工作流里
「不值得叫 LLM,但正则又写不出来」的那类判定。
- 语义 Lint — 在 CI 里检查是否符合团队命名规范与写作指南
- 模型路由 — 判定意图与难度,把简单请求分给便宜的模型
- 函数调用映射 — 把自然语言映射到类型固定的函数
- 日期与数值抽取 — 用分阶段抽取(SDE cascade)提升精度
实时判断:Doom 演示说明了什么
官方的 Doom 演示传入的不是图像,而是游戏状态的文本表示,每秒约调用 10 次 Jev 来决定动作,成本约每小时 7 美元。它值得看的不是游戏水平,而是「AI 的判断可以塞进 150 毫秒以内的循环」这个事实。嵌入式 UI 的分支、游戏内聊天的审核,都属于同一类。
开发者们在试什么
Qiita 的官方活动在 9 月时点已有 14 篇投稿,内容大致分三类。
- 用日语一次判定多项 — 把文章选题作为 state,一次性判定技术深度、实用性、对新手的易懂程度等 12 项(8 个 Score + 4 个 Choice)。发布平台的判定结果是 Qiita 92%/Zenn 8%(confidence 84%),技术深度 1.97/2.00(confidence 96%)。Playground 显示 96ms + 212ms
- 能否替代 LLM 的 if 判定 — 在没有早期访问的情况下,仅凭 SDK 与官方文档反推 confidence 的计算公式;同时报告了 SDK 0.6.0 的类型校验会拒绝官方 Quick Start 示例这一不一致
- 作为代理架构的比较 — 把「由 LLM 决定下一步」(如 Amazon Bedrock AgentCore)与「Jev 只返回分类、由程序分支」两种结构并列,归纳为「决定流程如何推进的责任,交给程序还是交给 AI」的差别
海外方面,Browserbase 用它做浏览器操作代理的判断,也有开发者用于交易代理和大规模邮件分拣。这些都没有公开具体数值。
用非英语输入时的注意事项
这是英语圈之外最需要留意的部分。官方关于 state 的说明写道:
「包括 CJK 在内的其他语言可以接受,但目前准确率低于英语」。Jev 的第一语言是英语,英语输入才是性能最好的场景。
实际用日语测试的报告里,紧急度判定返回了 0.97〜0.98,体感上是能跑的。但「跑得起来」和「达到了能投产的精度」是两回事。现实的推进顺序是三步。
- instructions 与 criteria 用英语写 — state 保持原语言,只把判定指令换成英语,让模型在自己最强的语言里接收指示
- 先用带标准答案的数据测一遍 — 准备 100〜300 条历史工单和人工标注,与 Jev 的判定对照。阈值是在这一步才定下来的
- 一开始把阈值设高,保留人工 — 只自动处理 confidence 0.9 以上的,其余交给人,再在运营中逐步提高自动化率
不擅长什么:官方主动公开的弱点
TypeSafe AI 在名为 model-jaggedness 的页面上,主动公开了 Jev 1.13 的短板。不看这一页就投产是会出事的。
| 弱点 | 具体会发生什么 |
|---|---|
| 只按字面读 | 限定词、否定、隐含条件都按字面理解。它回答的是「你写下的问题」,不是「你想问的问题」 |
| 数不清数量 | 字符数、出现次数、列表条数都不可靠,对象越大误差越大 |
| 数值精度不足 | 对十六进制、RGB 值处理弱,无法可靠判断两个值是否接近 |
| 日期时间比较弱 | 把日期当作文本而非有序的量来读,前后关系与时长计算不可靠 |
| 双重否定与复杂间接表达 | instructions 与 criteria 矛盾时会混乱 |
| 无关信息多了就掉精度 | state 中与判断无关的内容越多,准确率越低 |
此外,相关问题之间的数学一致性并不保证。分别用两个 Noul 问「是 A」和「不是 A」,概率未必加起来等于 1。需要一致性就合并成一个 Choice。
还有一点:官方明确写着对混进 state 里的对抗性指令是脆弱的。把用户输入直接放进 state 的结构,仍需另行防范提示注入。
哪些该换成 Jev,哪些不该
Jev 不是通用 LLM 的替代品,而是「把原本交给 LLM 的活儿分出去一部分」的工具。实际架构里的分工如下。
 Jev | 只做类型固定的判断,70〜500 毫秒返回
一个收窄到分类、评分、真假判定的模型,完全不写文本。用在选项可以事先列举、同种判断大量重复的场景。它的职责到「返回值与概率」为止,这个值怎么用,由应用代码决定。
 Claude | 写文章与长推理仍然交给 LLM
摘要、起草、代码生成、多步推理属于 Claude 的领域。Jev 负责它的护栏,以及输出的验证(引用是否真的在原文里)。两者不竞争,Jev 薄薄地夹在 LLM 的前后。
 ChatGPT | 只做分类的话,小模型也是选项
如果目的只是分类与抽取,ChatGPT 的 API 里也有便宜的模型(GPT-5.6 Luna 输入每百万 token 0.20 美元)。与 Jev 的差距大约是5 倍单价,加上输出是否计费、是否需要解析。如果已经在用 OpenAI,顺序应当是先确认便宜的模型够不够用,再做比较。
 Dify | 把工作流的分支条件从 LLM 挪到 Jev
在 Dify 这类工作流工具里,条件分支常常放一个 LLM 节点来判定。而这正是「选项事先已定」的判断,换成 Jev 之后,这一步的等待时间会从秒变成毫秒,直接反映在整条流程的延迟上。
 Claude Code | 找出代码里的判定点并改写
装上官方 skill 的 Claude Code,可以在仓库里找出「脆弱的解析处理」「被正则硬写出来的判定」,改写成 Jev 调用。把问题与 confidence 阈值集中到一个文件里,后续更容易复核。
常见问题
QJev 可以免费使用吗
模型本身按量计费,但控制台账单页显示有每月 5 美元的免费额度(2026 年 9 月时点)。输入每百万 token 只要 0.042 美元,光这个额度就能试相当多次。使用前需要通过候补名单获得邀请。
Q能用中文吗
能传中文 state,但官方明确写着「包括 CJK 在内的其他语言可以接受,但目前准确率低于英语」。投产前请用自己的标注数据确认精度与阈值。
Q能生成或摘要文本吗
不能。官方写明「没有接受过文本生成的训练」,强行串起来生成也质量低且慢。生成是 LLM 的工作。
Q能传图片或 PDF 吗
不能。state 只支持文本,形式为字符串、JSON 对象、字符串数组三种。需要先经过 OCR 或转写,再以文本传入。
QJev 和 Microsoft-Decision-1 该选哪个
价格(每百万输入 token 0.042 美元、输出免费)和提问类型相同,因此按提供方式来选。希望把合同・结算・认证统一到 Azure,选 Microsoft-Decision-1(在 Foundry 以预览提供,上下文 32,768 token);需要长输入或官方 SDK・智能体 skill,选 Jev(早期访问,上下文 64,000 token)。两者的请求形式几乎相同,把同样的问题发给两者、用自己的数据比较是最可靠的办法。
Q「输出免费」是什么意思
两款模型返回的都只是候选项的概率或数值,而不是文章。这部分返回内容的 token 不收费,账单只取决于输入(传入的文本和问题)的 token 数。Jev 返回的 `usage` 里也会记录输出 token 数,但只对输入计费。
QMicrosoft-Decision-1 能用于日语吗
没有公布支持语言列表。Microsoft 的发布文章只写了评估包含多语言任务,没有日语准确率的数字。Jev 也表示 CJK 准确率低于英语。无论哪一款,用于日语业务前都请先用自己的标注数据测量准确率。
Q「快 200 倍、便宜 400 倍」是真的吗
这些全部是 TypeSafe AI 自己的测量,出自自建的「workflow evals」评测框架,所用工作流的内容未公开,也还没有第三方验证。量级上的差距从价目表就能确认,但你自己那套处理的倍率,要自己测。
小结
Jev 带来的不是新的性能,而是新的分工。把原本整包交给 LLM 的工作中,「选项事先已定的判断」单独切出来,交给快上、便宜上都差着数量级的专用模型;剩下的生成与推理仍归 LLM。
想先试一下的话,从现在生产环境里交给 LLM 的处理中,挑一处需要把返回值当 JSON 解析的地方。那就是 Jev 的守备范围。把同样的输入取 10 条丢进 Playground,看判定是否一致,就足以判断能不能替换。
投产前要定下两件事:confidence 的阈值(按操作的轻重分别设定),以及低于阈值的部分由谁来看。这两件定好了,判断出错时就不会变成事故。
本文信息基于 2026 年 9 月 19 日时点 TypeSafe AI 官网、官方文档与官方博客公开的内容,以及已公开的实测报告(2026 年 10 月 13 日依据 TypeSafe AI 与 Microsoft 的官网、官方文档和博客,补充了 Microsoft-Decision-1 一节和 Jev 的最新状况)。Jev 处于早期访问阶段,规格、价格与速率限制可能变更。最新信息请以官网为准。
本文介绍的 AI 工具

相关文章
Claude Fable 5、GPT-5.5、Gemini 3.1 Pro该如何选择?性能、价格、使用场景全面对比【2026年7月版】
全面对比2026年上半年三强最新旗舰模型Claude Fable 5、GPT-5.5、Gemini 3.1 Pro。以官方数据为主,涵盖基准测试表现、API定价、上下文窗口、多模态支持,以及ChatGPT Plus/Claude Pro/Google AI Pro等消费级方案的使用方法,并按用途给出选购建议。
GPT-6 Astra 是什么【2026 年 9 月最新】ChatGPT 哪些套餐可用・API 价格・与 GPT-5.6 的分工
OpenAI 于 2026 年 9 月 3 日(美国时间)发布的 GPT-6 Astra,正如「凡是人能在电脑上做的事,它都能代劳」所说,是一款面向电脑操作与跨多步骤长任务的旗舰模型。OSWorld 2.0 得分 72.6%,单个任务的耗时从 GPT-5.6 Sol 的约 75 分钟缩短到约 40 分钟,减少 47%。本文先用基准测试确认改变了什么,再基于 OpenAI 的官方公告、帮助中心和模型页面,整理 ChatGPT 各套餐分别在哪里可用(Pro ¥16,800/¥30,000、Business、Enterprise 在 Chat 中为「GPT-6 Pro」;Plus ¥3,000 经由 ChatGPT Work 与 Codex;免费版・Go 不提供)、每周 50 条・200 条等上限、API 单价(输入 $10/输出 $50,为 Sol 的 2.5 倍)与 Sol・Terra・Luna 的分工,以及切换时确认提问变多、对技能文件更敏感等行为变化。
什么是 Cloudflare OS?开源 AI 智能体工作台深度解析(架构·Gatekeeper·自托管·价格)
Cloudflare 于 2026 年 8 月 5 日开源发布 AI 智能体工作台 Cloudflare OS。本文依据官方博客与 GitHub,讲解其从零权限出发的 Gatekeeper 安全模型、经由 AI Gateway 的模型选择与成本管理、Gadget(小型自制应用)、部署到自有 Cloudflare 账户的步骤,以及价格。
Sakana AI Fugu 使用方法|从API密钥签发到Claude Code接入,价格、免费额度与性能解说
讲解 Sakana AI 的多智能体平台 Fugu:在 console.sakana.ai 签发API密钥、调用兼容OpenAI的API,以及与 Codex、Claude Code 的接入步骤。并介绍 Fugu/Fugu Ultra/Fugu Cyber 的区分使用、价格与免费额度的有无,以及基准测试表现。