Claude Fable 5.2とは【2026年11月9日公開】料金(API・プラン別)・ベンチマーク・Opus 5.5との使い分け・Mythos 5.2との違い
Anthropicは2026年11月9日、最上位モデルの新版「Claude Fable 5.2」と、同じモデルで安全機構の一部を外した「Claude Mythos 5.2」を公開しました。出力はFable 5.1より最大30%速く、APIの料金は入力$8・出力$40に下がっています。この記事では、公式発表・ドキュメント・ヘルプセンターにもとづいて、ベンチマーク(Opus 5.5・GPT-6 Astraとの比較)、1,000エージェントでのフェルマーの最終定理の形式化や電子機器の設計などの事例、APIとプラン別の料金(Proは使用量クレジット、Max・Ultraは週の上限の50%まで)、使い方、Opus 5.5との使い分け、開発者向けの変更点、安全性とデータの扱いを整理します。
Anthropic は2026年11月9日、最上位のモデル「Fable」の新版 Claude Fable 5.2 と、同じモデルで安全機構の一部を外した Claude Mythos 5.2 を公開しました。コーディング・推論・画像の読み取りが伸び、出力は Fable 5.1 より最大30%速く、API の料金は入力$8・出力$40に下がっています。
この記事では、Anthropic の公式発表・開発者向けドキュメント・ヘルプセンターにもとづいて、何ができるようになったか、ベンチマーク、API とプラン別の料金、使い方、Opus 5.5 との使い分け、開発者が気をつける変更点、安全性とデータの扱いを整理します(2026年11月10日時点)。
結論|先に3行で
Fable 5.2 は、難しい技術の仕事に向けた Anthropic の最上位モデルです。ほぼすべてのベンチマークで Opus 5.5 を上回りますが、ふだんの仕事は Opus 5.5 から始めるよう公式も勧めています。
API は100万トークンあたり入力$8・出力$40で、Fable 5.1 から2割安くなりました。アプリでは Max・Ultra なら週の上限の50%まで追加料金なしで、Pro は使用量クレジット(従量課金)で使います。
Pro と Team の Standard 席は、11月16日まで追加料金なしで試せます。週の上限の50%まで使え、11月9日より前からの有料契約なら、上限を戻すリセットも1回付きます。Free プランでは使えません。
claude-fable-5-2(Amazon Bedrock は anthropic.claude-fable-5-2)Claude Fable 5.2とは|Mythos 5.2 との違い
Fable は、Anthropic が「もっとも手ごわい技術の課題に取り組むため」に用意している最上位のモデルです。2026年6月の Fable 5、8月31日の Fable 5.1 に続く3つ目の版にあたります。
Fable 5.2 と Mythos 5.2 は、同じモデルです。違いは安全機構にあります。
| Claude Fable 5.2 | Claude Mythos 5.2 | |
|---|---|---|
| 安全機構 | サイバーセキュリティと生物学の分野で、悪用を防ぐ強い安全機構がある | その一部を外している |
| 使える人 | だれでも(有料プラン・API) | 審査を通った組織だけ(Cyber Verification Program・Life Sciences Verification Program) |
| 向いている使い方 | 一般の仕事 | 脆弱性の発見・修正、生物医学の研究 |
| 料金・仕様 | 入力$8・出力$40 | Fable 5.2 と同じ |
Fable 5.2 では、侵入テストやエクスプロイトの作成などリスクの高いサイバーの作業と、研究向けの生物学のほとんどの作業が、安全機構で止められます。止められた質問には、代わりにサイバーは Claude Opus 4.8、生物学は Claude Opus 5 が答えます。
前の版の Fable 5 については、Claude Fable 5の記事にまとめています。
何が変わったか|Fable 5.1 からの主な違い
Fable 5.1 との比較
Fable 5.1 は$10/$50
Fable 5.1 との比較
- 伝え方がはっきりした — 公式によると、試した人たちは「これまでの Fable より説明が明快」と評価しています
- 少ないトークンで難しい仕事をこなす — 標準の medium effort(Claude のアプリと Claude Code の既定)で、Fable 5.1 より少ないトークンで難しい課題を終えられます
- 高速モード — 料金は2倍(入力$16・出力$80)で、トークンの生成が最大2.5倍速くなります。Claude Code、Claude API、Google Cloud、Microsoft Foundry で使えます
- 不要なブロックの内訳 — claude.ai・Claude Code・Cowork での初期のテストで、サイバーが約60%減、生物学が約40%減。守りの強さは Fable 5.1 と同じとしています
- 蒸留への対策 — 出力を集めて別のモデルに学ばせる「蒸留」への守りが、これまでで一番強くなりました
ベンチマーク|ほぼすべての項目で Opus 5.5 を上回る
公式発表の比較表から、Fable 5.2 が対象になっている項目を抜き出しました。いずれも Anthropic が公表した数値で、各モデルのもっとも高い effort(思考の深さの設定)の結果です。
| ベンチマーク | 分野 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
| FrontierCode 2.0 | エージェント型コーディング | 49.1% | 32.4% | 45.5% | 42.8% | 41.1%(Medium) |
| FrontierSWE v2 | エージェント型コーディング | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench | 業務の自動化 | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 科学研究のエージェント | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| WANDR | エージェント型の検索 | 82.1% | 68.7% | 72.3% | — | — |
| OSWorld 2.1 | コンピューター操作 | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim | ロボットの操作 | 64.9% | 27.6% | 39.4% | 29.8% | — |
| AA-Briefcase v1.1(採点) | 知識労働 | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| AA-Briefcase v1.1(Elo) | 知識労働 | 1785 | 1669 | 1800 | 1569 | 1611 |
| Remote Labor Index | 知識労働 | 41.3% | 17.9% | 21.3% | 20.8% | — |
| Humanity's Last Exam(ツールあり) | 分野をまたぐ推論 | 74.2% | 65.6% | 67.7% | 57.2% | — |
| Chartography(ツールなし) | グラフの読み取り | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
出典: Anthropic の発表の比較表。Fable 5.2・Fable 5.1・Opus 5.5 は安全機構をオンにした結果。Fable 5.2 の FrontierCode 2.0 は Xhigh、Remote Labor Index は High の結果。Terminal-Bench-Science は Mythos 5.2 だと75.3%。
Fable 5.2 が1位でないのは、業務の自動化(AutomationBench)で Gemini 4 Carbon に、知識労働の Elo で Opus 5.5 にわずかに届かなかった2つです。伸びが大きいのは、ロボットの操作(27.6%→64.9%)、在宅のフリーランスに頼むような実務をどこまで仕上げられるかを見る Remote Labor Index(17.9%→41.3%)、グラフの読み取り(44.8%→73.4%)です。
サイバーセキュリティとタンパク質の設計は、安全機構を外した Mythos 5.2 で測っています。脆弱性の再発見(CVE Rediscovery)は89.6%で、Mythos 5.1(78.3%)と Opus 5.5(81.3%)を上回りました。
effort と費用|High で Opus 5.5 の最高点に並び、費用は約半分
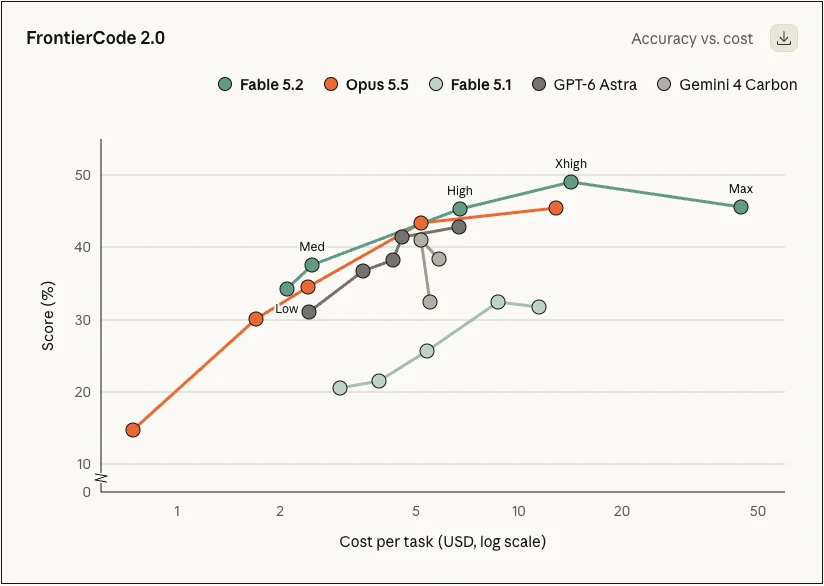
FrontierCode 2.0 は、モデルが書いたコードの変更を、オープンソースのメンテナーが取り込むかどうかで採点するベンチマークです。Fable 5.2 は High で45.3%と、Opus 5.5 の最高点(45.5%)にほぼ並び、1課題あたりの費用は約半分でした。Xhigh では49.1%で、Anthropic が試した公開済みのモデルの中で一番高い点です。
effort は low・medium・high・xhigh・max の5段階です。API の既定は high で、公式は「性能の伸びのほとんどは high で得られる」として、まず high から始め、もっとも難しい長時間のコーディングやエージェントの作業で xhigh に上げるよう勧めています。
公式が紹介した事例|1,000エージェント・OS・電子機器・ロボット
フェルマーの最終定理を、1,000エージェントで約30時間で形式化
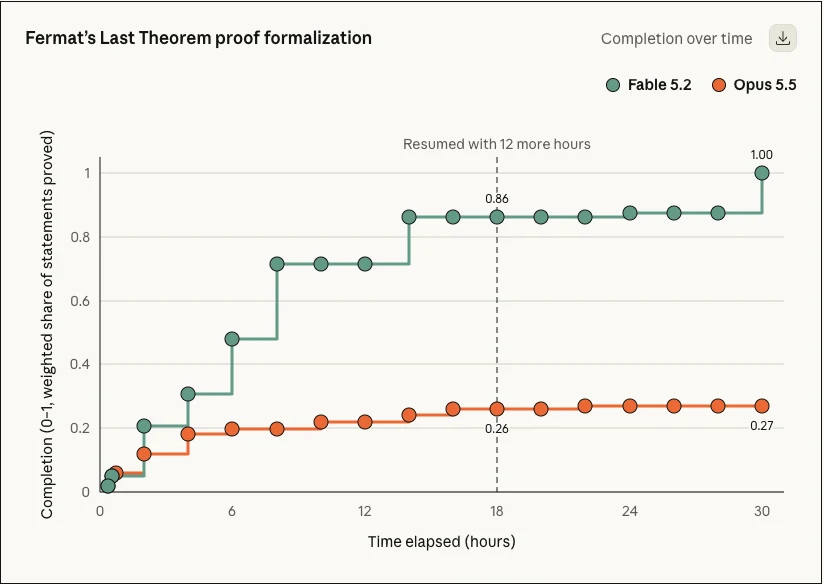
数学の証明を、コンピューターが1行ずつ確かめられる言葉(Lean)に書き直す「形式化」の実験です。1体のリーダーと999体の補助役からなる Fable 5.2 のエージェントのチームが、フェルマーの最終定理の形式化を約30時間でやり遂げました。同じ構成の Opus 5.5 は、18時間で26%、30時間でも27%にとどまっています。
9月に公開した最初の形式化は、研究者の指示と専用の仕組みを使って11日かかりました。今回は、60個の中間の命題のリストなど最小限の材料だけを渡し、進め方は指示していません。リーダーは最初の10分で、共有のデータベースに作業の割り当てや進捗を書く5つの表を作り、チームをまとめたといいます。かかった出力トークンは最初の形式化の3分の1、証明の長さは7分の1でした(実験の詳しい記録)。
空のフォルダから、8日間でOSを作る
Anthropic のエンジニアが試しに「OSの試作品を設計して」と頼んだところ、Fable 5.2 は空のフォルダから始めて1,000を超えるサブエージェントを指揮し、8日間休まずにコードを書き、テストし、レビューしました。できあがったOSはノートパソコンで起動し、ディスク・キーボード・ネットワークのドライバー、ファイルの保存、ウィンドウ、ログイン画面、インストーラー、Claude の機能まで備えていたといいます。
社内では、Python で書かれた重要な本番サービスを Rust に移し替え、起動が約26倍速くなった例も紹介されています。Anthropic のコードベースに取り込まれる変更の9割以上は、すでに Claude が(人の指示のもとで)書いているそうです。
1段落の指示から、動く電子機器を3台設計
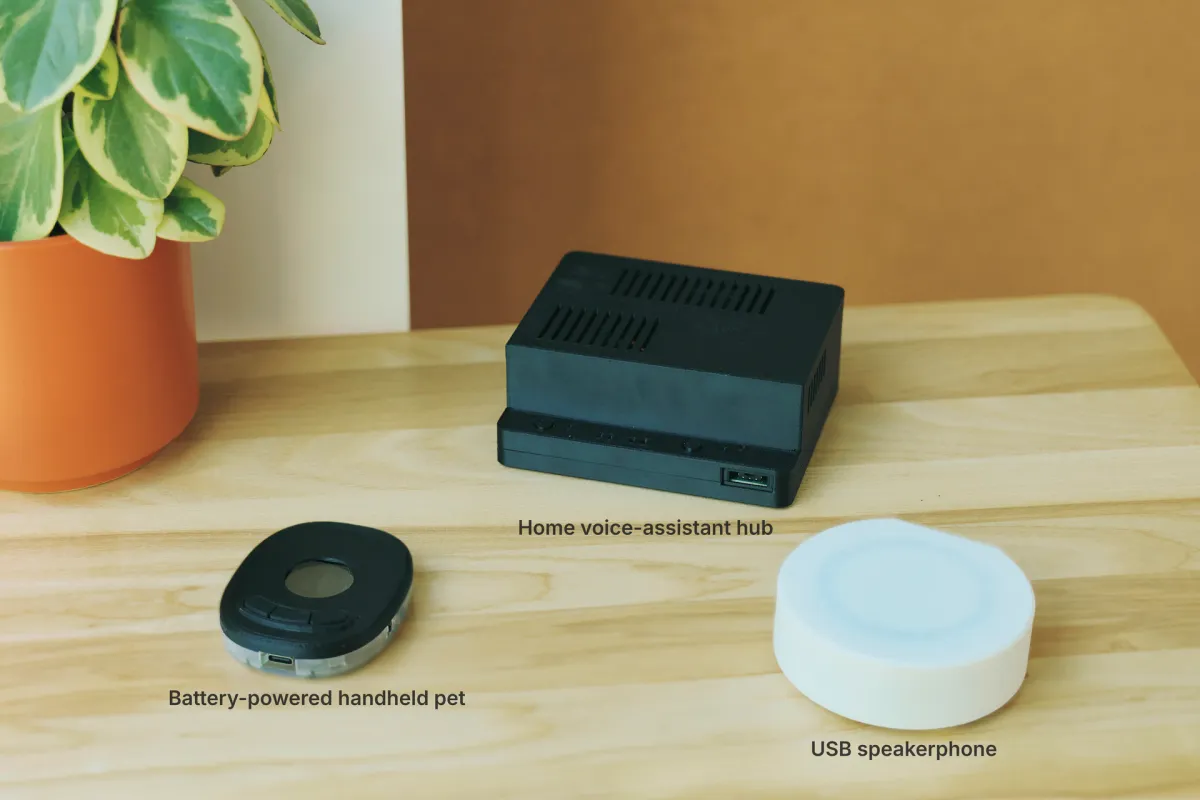
回路基板を作る Diode 社と組んで、1段落の指示から電子機器を3台設計させた実験です。Fable 5.2 は仕様を書き、米国の販売店で手に入る部品を選び、4層の基板の配線を引き、ケースを CAD で設計し、ソフトウェアまで書きました。どの基板も1日足らずで製造できる状態になり、3台とも電気的な手直しなしで動きました。
部品の配置と配線の腕を測る Diode 社のベンチマーク「PCB Gym」では、Fable 5 の25%に対して Fable 5.2 は69%でした(Anthropic の研究ページ)。ただし、3台はまだ試作品で、認証や量産向けの検証は受けていません。
ロボットの操作|RoboDojo で他社のモデルの2倍超
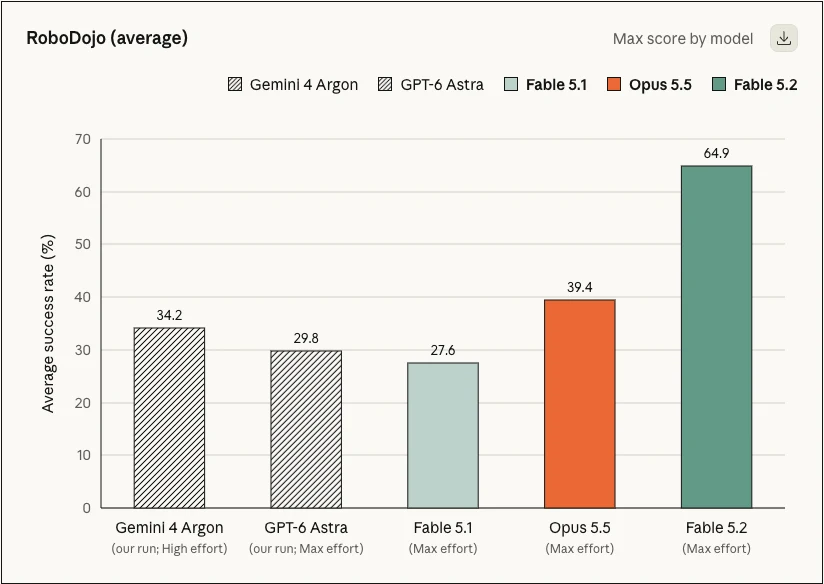
カメラの映像から2本腕のロボットを動かす RoboDojo のシミュレーションで、Fable 5.2 は64.9%と、GPT-6 Astra(29.8%)や Fable 5.1(27.6%)の2倍を超えました。発表の動画では、Fable 5.2 が動かすロボットが、パズルキューブを解く、ボトルのふたを開ける、ロボットの絵を描くといった作業をこなしています。ロボットの操作を特に学習していない作業でも、これまでの Claude より大きく上達したとしています。
科学の研究
- 理論物理 — ブラックホールに関する理論物理の未解決問題を2つ解きました(ホログラフィー双対性にもとづくもの。それぞれ論文の草稿を公開)
- タンパク質 — Mythos 5.2 が、遺伝子治療に使うウイルスの殻(カプシド)全体の構造を予測する新しい方法を考え、試した34種のうち28種で正確に再現しました
- 材料科学 — Discovered Materials 社によると、計算の重い Quantum ESPRESSO のフォノン計算を同じ GPU で平均約36倍速くし、13件の計算が3.3時間から4分未満になりました
試した企業の声
公式発表に寄せられた、早期に試した企業のコメントの一部を要約します。
| 企業 | コメント(要約) |
|---|---|
| Vercel | 他のモデルで何週間も進めていた案件が、数日で仕上がってレビューも通った。こちらの意図を外さない |
| Shopify | ざっくりしたアイデアを詰めるのが得意。数往復で「それで進めて」と任せられる。スタッフレベルのエンジニアと働いている感覚 |
| Uber | 10〜12時間のセキュリティ監査を任せたら、約170のレビュー役のエージェントを走らせ、報告書・修正のプルリクエスト・方針の案まで出してきた |
| Oracle | 国別の債務を集計するテストで、他の2つのモデルは値を5〜8倍に誤ったが、Fable 5.2 の SQL は正しい結果を返した |
| Snowflake | 103のデータエンジニアリングの課題からなるベンチマークで、測った中でもっとも強いモデルだった |
| Cognition | 分からないことは分からないと言い、でたらめを言わない。測るまで数字は出さないと答えた |
公式の発表以外で話題になった使い方|1回のお願いで、曲から動画を作る
公開の翌日には、Fable 5.2 に「今の実力を見せつける最強の動画を見せて」と頼んだら、曲を作るところから始めて音ハメの効いた動画を仕上げた、という X の投稿が話題になりました。この動画が示したことと、それを量産の仕組みにする考え方は、動画ファクトリーの記事で解説しています。
料金|API とプラン別の使える範囲
API の料金
| 区分 | 100万トークンあたり | 円換算 |
|---|---|---|
| 入力 | $8 | 約1,264円 |
| 出力 | $40 | 約6,320円 |
| キャッシュの書き込み(5分/1時間) | $10/$16 | 約1,580円/約2,528円 |
| キャッシュの読み取り | $0.20(入力の2.5%) | 約32円 |
| Batch API | 入力・出力とも50%引き($4/$20) | 約632円/約3,160円 |
| 高速モード | 入力$16・出力$80 | 約2,528円/約12,640円 |
円換算は1ドル=158.0円(2026年11月9日の欧州中央銀行の参照レートから算出)。
- 100万トークンまで同じ単価 — 長い入力でも割増しはありません(90万トークンの入力も9,000トークンと同じ単価)
- 米国内だけで処理させると1.1倍 —
inference_geo: "us"を指定した場合です。既定のグローバルは標準の料金です - 高速モードは Batch API と併用できません
入力10万トークン・出力1万トークンのリクエストなら、概算で Fable 5.2 が$1.20(約190円)、Fable 5.1 が$1.50、Opus 5.5 が$0.60です。Fable 5.2 は Opus 5.5 の2倍の単価ですが、公式は「High の Fable 5.2 は、Max の Opus 5.5 と同じくらいの点を約半分の費用で出した」としています。難しい課題では、単価だけで比べないほうがよいということです。
Claude のプランで使える範囲
Fable 5.2 は、Free を除くすべての有料プランで使えます。ただし、プランに含まれるかどうかが分かれます。
| プラン | 月額(ドル・税抜) | Fable 5.2 の扱い |
|---|---|---|
| Free | $0 | 使えない |
| Pro | $20 | プランの上限には含まれず、使用量クレジット(従量課金)で使う |
| Max | $100 | プランに含まれる。週の上限の50%まで追加料金なし |
| Ultra | $200 | プランに含まれる。週の上限の50%まで追加料金なし |
| Team(Standard 席) | 1席 $25 | 使用量クレジットで使う |
| Team(Premium 席) | 1席 $125 | プランに含まれる。週の上限の50%まで |
| Enterprise | 契約による | Premium 席はプランに含まれ、Standard 席は組織が許可すれば使用量クレジットで使う。従量課金の契約は API の料金 |
- Fable は上限の減りが速い — ほかのモデルより早く上限に近づきます。「設定 > 使用量」で残りを確かめられます
- Max・Ultra で50%を使い切ったら — 使用量クレジットで Fable を使い続けるか、ほかのモデルに切り替えます
- Enterprise は、まず管理者が有効にする — 公開から7日後には、Fable のモデルを許可しているロールへ自動で追加されます(管理者が先に止めた場合を除く)
公開を記念した特典(11月9日から): Pro と Team の Standard 席は、11月16日(米国太平洋時間)まで、週の上限の50%まで Fable を追加料金なしで使えます。上限を戻す「リセット」も1回付きます(11月16日まで)。Max・Ultra・Team の Premium 席などは、契約期間に応じてリセットが1〜3回付きます(6か月未満は1回、6〜12か月は2回、12か月超は3回。期限は2027年3月8日)。リセットは11月9日午前10時(太平洋時間)より前に有料の支払いが始まっていたアカウントが対象で、「設定 > 使用量」の「Reset for free」から使います(ヘルプセンター)。
プランの料金と内容は、Claudeの製品ページにまとめています。
使い方
 Claude | Web・デスクトップ・スマホは、モデルの選択から「Fable 5.2」
Claude の Web 版・デスクトップアプリ・スマホアプリでは、モデルの選択(モデルピッカー)から「Fable 5.2」を選びます。既定のモデルは変わらないので、使うたびに選ぶ必要があります。
ほかに Cowork、Claude Design、Claude for Microsoft 365、Claude Tag でも使えます。Cowork で使うには、デスクトップアプリを最新にしておきます。「Fable 5.1」「Fable 5」も引き続き選べます。
 Claude Code | バージョン2.1.321以上で使える
Claude Code で Fable 5.2 を使うには、バージョン2.1.321以上が必要です。モデルの切り替えで Fable 5.2 を選びます。Claude Code の既定の effort は medium で、高速モードも使えます。
Claude Code の使い方は、Claude Codeの製品ページをご覧ください。
API で使う
API ではモデルIDに claude-fable-5-2 を指定します。Claude API のほか、Amazon Bedrock(anthropic.claude-fable-5-2)、Google Cloud、Microsoft Foundry、Claude Platform on AWS で同じモデルを使えます。提供終了は、2027年11月9日より前にはならないとされています。
Opus 5.5 との使い分け
公式は、ふだんのコーディングや知識労働は Claude Opus 5.5 から始め、作業の規模や難しさに応じて Fable 5.2 に上げるよう勧めています。軽い作業なら Sonnet 5.5・Haiku 5.5 に下げます。
| モデル | 向いている仕事 | API の料金(入力/出力) | 既定の effort(API) |
|---|---|---|---|
| Fable 5.2 | 何時間も続くエージェントの作業、深い調査、難しい推論。Opus 5.5 を高い effort にしても足りないとき | $8/$40 | high |
| Opus 5.5 | 長時間のエージェント型コーディングと知識労働。ふだん使いの本命 | $4/$20 | medium |
| Sonnet 5.5 | 速さと賢さのバランス | $2/$10 | high |
| Haiku 5.5 | 分類・抽出など、量が多く速さが要る処理 | $0.10/$0.50から | medium |
組み合わせて使う方法も、公式に用意されています。
- Advisor(相談役) — Haiku・Sonnet・Opus が作業を進め、難しいところだけ Fable 5.2 に相談します
- Orchestrator(指揮役) — Fable 5.2 が全体を指揮し、簡単な作業を小さいモデルに任せます
開発者が気をつけること|Fable 5.1 からの変更点
公式ドキュメントは、Fable 5.1 からの乗り換えでコードが動かなくなりうる変更を4つ挙げています。Claude Code・claude.ai・Claude Managed Agents・Claude Agent SDK がリクエストを組み立てている場合は、1つ目の対応は要りません。
| 変更 | 何が起きるか | どうするか |
|---|---|---|
| 過去のやり取りの書き換え | システムプロンプト・ツール・前のメッセージを変えてから思考ブロックを送り返すと400エラー。Fable 5.1 では新しいアカウントだけだったが、すべてのアカウントが対象に | 履歴は書き換えず、後ろに足していくだけにする |
| 思考ブロックを読めるモデル | Fable 5.2 の思考ブロックは Fable 5.2 と Mythos 5.2 しか読めない。途中でほかのモデルに切り替えると、その分の推論が引き継がれない | 切り替えるなら、推論が引き継がれない前提で組む |
| 以前のコンピューター操作ツール | computer_20251124 は Amazon Bedrock 以外では400エラー | computer_toolset_20260801 に移す |
| advisor ツールの相談役 | 実行役が Fable 5.2 のとき、相談役に Fable 5.1 などを指定すると400エラー | 相談役を claude-fable-5-2 か claude-mythos-5-2 にする |
このほかの決まりもあります。
- 思考は常にオン — 適応型の思考(adaptive thinking)だけで、オフにはできません。深さは effort で調整します
- ツールの強制呼び出しはできない —
tool_choiceの any・tool はエラーになります。決まった形の JSON がほしいときは strict tool use か JSON 出力を使います - temperature・top_p・top_k は送らない
- データは30日間保存される — Anthropic が特に認めた場合を除き、データを保存しない契約(ゼロデータリテンション)では使えません
ふるまいの違いとして、「考えずに答えて」という指示を書いても medium 以上では考えてから答える、長い作業で残りの作業の一覧を出して途中でターンを終えることがある(low・medium で多い)、といった点も挙げられています。プロンプトの調整は公式の「Prompting Claude Fable 5.2」にまとまっています。
安全性とデータの扱い
安全性の評価
Anthropic は、Fable 5.2 が重大な場面で危険なふるまいをするリスクは「低い」と評価しています。公開前には、英国の AI Security Institute や METR など外部の評価機関も試しています。
- ふるまいの監査 — 約1,900の場面で好ましくないふるまいを測る自動の監査で、Mythos 5.2 は2.67点(1〜10点・低いほど良い)でした。Opus 5.5 は2.79、Sonnet 5.5 は3.10、Mythos 5.1 は3.28です
- サンドボックスからの脱出 — わざと弱点を作ったサンドボックスで外の認証情報やファイルを使った割合は3.1%で、Opus 5.5(3.3%)と同じくらい、Mythos 5(39%)・Mythos 5.1(21%)より大きく下がりました
- 課題も公表 — Fable 5.2 と Mythos 5.2 は、評価されていると疑う発言がこれまでのモデルより多く、実際の場面でのふるまいを評価しにくくなっているとしています
- AI の研究開発の能力は抑えた — AI の開発を直接速めうる一部の研究能力は、学習の段階で Opus 5.5 と同じくらいに抑えています
データの扱い
Fable 5.2 は、能力が高く悪用されたときのリスクも大きいモデルとして「Covered Model」に指定されています。複数のリクエストにまたがる悪用を見つけるため、入力と出力は少なくとも30日間保存され、その後自動で削除されます。安全のための調査の対象になった場合や、法律で求められた場合は除きます。
データを保存できない事情のある企業向けには、監視用のデータを自社のクラウドに置ける「Enterprise Frontier Safeguards」が用意され、Bridgewater・Salesforce・Stripe などで試験的に提供されています。
関係する製品
 ChatGPT | GPT-6 Astra は API が入力$10・出力$50
OpenAI の最上位モデル GPT-6 Astra は、Anthropic の比較表では FrontierCode 2.0 が42.8%、OSWorld 2.1 が79.5%でした。API の料金は、9月の公開時点で入力$10・出力$50です。詳しくはGPT-6 Astraの記事をご覧ください。
 Gemini | Gemini 4 Carbon は業務の自動化で上回るが、提供は一部だけ
Google が10月28日に発表した Gemini 4 Carbon は、Anthropic の比較表では、業務の自動化(AutomationBench 53.9%)で Fable 5.2(51.4%)を上回りました。ただし10月末の時点では、一部のサイバー防御担当者にだけ提供されています。詳しくはGeminiの製品ページをご覧ください。
よくある質問
claude-fable-5-2、Amazon Bedrock は anthropic.claude-fable-5-2 ですまとめ
- 2026年11月9日、Anthropic が最上位モデルの新版 Claude Fable 5.2 と、安全機構の一部を外した Mythos 5.2 を公開した
- ほぼすべてのベンチマークで Opus 5.5 を上回り、ロボットの操作・フリーランスに頼むような実務・グラフの読み取りで大きく伸びた
- 1,000エージェントでのフェルマーの最終定理の形式化(約30時間)、8日間でのOSの開発、電子機器3台の設計など、長時間の大きな仕事の事例が並ぶ
- API は入力$8・出力$40で、Fable 5.1 から2割安い。アプリではMax・Ultra は週の上限の50%まで含まれ、Pro は使用量クレジット。Pro は11月16日まで追加料金なしで試せる
- ふだんの仕事は Opus 5.5 から始め、難しい仕事で Fable 5.2 に上げるのが公式の勧め。開発者は思考ブロックの扱いなど4つの変更に注意
あわせて読みたい
- Claude Fable 5とは — Fable シリーズの最初の版
- 動画ファクトリーとは — Fable 5.2 が1回のお願いで作った動画と、それを量産する考え方
- GPT-6 Astraとは — OpenAI の最上位モデル
- Claudeの製品ページ — プランの料金と機能
本記事の情報は2026年11月10日時点で、Anthropic の発表「Introducing Claude Fable 5.2 and Claude Mythos 5.2」(2026年11月9日)、Claude Fable 5.2 のドキュメント・What's new in Claude Fable 5.2・料金、ヘルプセンターの「Claude Fable models on your plan」「Claude Fable 5.2 launch offers」「Covered Models」、Anthropic の研究ページ「Testing Claude on real-world electronics design」、claude.dev のブログ「Safely scaling multi-agent teams with Claude Fable 5.2」にもとづきます。図版は Anthropic の公開ページから引用しています。料金・提供状況は変わることがあるため、最新の情報は公式サイトをご確認ください。
AI tools featured in this article
Related articles
What Jev Is [October 2026]: The AI That Generates No Text — How to Use It, Pricing, and How It Differs from Microsoft-Decision-1
On 9 October 2026, Microsoft released Microsoft-Decision-1, a decision model at the same price as Jev ($0.042 per million input tokens, free output) and with the same question types. This article explains what Jev — released by TypeSafe AI on 15 September 2026 — is: a System One model that generates no text and returns Choice (classification), Score (rating) and Noul (a 0–1 truth value) with probabilities; speculative fan-out, where stacking questions barely changes latency; how to get started from the waitlist to the Python SDK, HTTP API and Claude Code skill; routing low-confidence answers to people; and use cases. It then compares Jev with Microsoft-Decision-1 (access, context length, availability, Japanese support), explains which to choose and whether you can use them from Japan, and covers Jev's latest status in October (Series A, rate limits, OpenRouter listing). It also covers the official note that CJK accuracy is lower than English and the weak spots TypeSafe publishes itself.
Claude Fable 5 vs. GPT-5.5 vs. Gemini 3.1 Pro: Which Should You Choose? A Deep Dive into Performance, Pricing, and Use Cases [July 2026]
A thorough comparison of the latest flagship models from the industry's three leading AI labs, all released in the first half of 2026: Claude Fable 5, GPT-5.5, and Gemini 3.1 Pro. Covers benchmark performance, API pricing, context windows, multimodal support, and how to use them on consumer plans like ChatGPT Plus, Claude Pro, and Google AI Pro — with recommendations by use case, based primarily on official data.
What GPT-6 Astra Is [September 2026]: Which ChatGPT Plans Include It, API Pricing, and How to Split Work with GPT-5.6
GPT-6 Astra, announced by OpenAI on 3 September 2026 (US time), is a flagship tuned for computer use and long, multi-step work, true to the pitch that it "can do anything a person can do on a computer." It scores 72.6% on OSWorld 2.0, and time per task drops 47% from GPT-5.6 Sol's roughly 75 minutes to roughly 40. This article checks what changed against the benchmarks, then lays out where each ChatGPT plan can use it (Pro at ¥16,800 / ¥30,000, Business and Enterprise get "GPT-6 Pro" in Chat; Plus at ¥3,000 gets it through ChatGPT Work and Codex; Free and Go do not), the caps such as 50 or 200 messages a week, API pricing ($10 input / $50 output, 2.5x Sol) and how to split work with Sol, Terra and Luna, and the behaviour changes on switching (more clarifying questions, more sensitivity to skill files), based on OpenAI's announcement, Help Center and model page.
What Is Cloudflare OS? A Deep Dive into the Open-Source AI Agent Workspace (Architecture, Gatekeepers, Self-Hosting, Pricing)
Cloudflare open-sourced Cloudflare OS, an AI agent workspace, on August 5, 2026. This article covers its zero-permission Gatekeeper security, model selection and cost control via AI Gateway, Gadgets (small personal apps), how to deploy it into your own Cloudflare account, and pricing — based on the official blog and GitHub.
How to Use Sakana AI Fugu: From API Key to Claude Code | Pricing, Free Tier, and Performance
A guide to Sakana AI's multi-agent platform Fugu: issuing an API key at console.sakana.ai, calling the OpenAI-compatible API, and wiring it into Codex and Claude Code. Covers choosing between Fugu, Fugu Ultra, and Fugu Cyber, pricing and whether a free tier exists, and benchmark performance.